Corso Machine Learning Engineer · Modulo 02 · Matematica e statistica · Lezione 4
Obiettivo. Trasformare gli esiti di un esperimento in numeri, descriverne il comportamento con la loro distribuzione, e riassumerlo con due indicatori: il valore atteso (dove sta il centro) e la varianza (quanto si disperde). Alla fine conosci le distribuzioni che incontrerai ovunque (Bernoulli, binomiale, Poisson, uniforme, esponenziale, normale), sai derivarne media e varianza, e hai visto con simulazioni la legge dei grandi numeri e il teorema del limite centrale, compreso il caso in cui non funzionano.
Falso mito da sfatare. «Tutto in natura è distribuito come una campana (normale).» Molti fenomeni (tempi di attesa, dimensioni di file, patrimoni) hanno code lunghe in cui la normale sbaglia di ordini di grandezza, e per alcune distribuzioni la media non esiste. Lo dimostreremo con un esperimento.
Introduzione
Nella lezione precedente la probabilità era una funzione sugli eventi (insiemi). Ma i dati sono numeri: l'altezza di una persona, il numero di clic, il tempo di attesa. Una variabile aleatoria è il ponte: assegna un numero a ogni esito. Su questi numeri si può fare ciò che si fa con i numeri (medie, somme, confronti), mantenendo il rigore della probabilità. I termini che servono sono spiegati qui al primo uso e riassunti nel glossario finale.
Il percorso procede dalla definizione di variabile aleatoria al valore atteso e alla varianza, poi alle distribuzioni notevoli (Bernoulli, binomiale, Poisson, uniforme, esponenziale, normale), alla legge dei grandi numeri e al teorema del limite centrale, e si conclude con il caso in cui questi teoremi non valgono (le code pesanti) e con covarianza e correlazione. Servono i concetti di probabilità e i coefficienti binomiali della lezione precedente.
Variabili aleatorie
L'analogia: il gettone con il numero
Ogni esito dell'esperimento riceve un'etichetta numerica, come un gettone con un numero stampato. Lanci due dadi: l'esito è la coppia (3, 5), ma a te interessa la somma 8. La somma è una variabile aleatoria X: una funzione dallo spazio campionario Ω ai numeri reali, X : Ω → ℝ (la lezione 1 sulle funzioni, ora applicata). «Aleatoria» perché dipende dall'esito, che non conosci in anticipo.
Si distinguono due famiglie:
- Discreta: assume un elenco numerabile di valori (il punteggio di un dado, il numero di clic).
- Continua: assume qualunque valore in un intervallo (un tempo, una lunghezza).
La distinzione conta perché cambia lo strumento: per le discrete si sommano masse, per le continue si integrano densità. Quasi tutto ciò che segue ha due versioni, una con le somme e una con gli integrali, ed è la stessa idea scritta due volte; useremo le somme per le dimostrazioni e le simulazioni per le continue.
Variabili discrete: la funzione di massa. La funzione di massa di probabilità (PMF) p(x) = P(X = x) dice quanta probabilità «pesa» su ciascun valore. Le masse sono non negative e sommano a 1.
Variabili continue: la densità. Per una variabile continua la probabilità di un valore preciso è zero (nessuno ha un'altezza di esattamente 175.000000... cm). Si parla invece di funzione di densità f(x): la probabilità di cadere tra a e b è l'area sotto la curva tra a e b. L'analogia è la densità di un materiale: un pezzo di metallo ha una densità in ogni punto, ma la massa è un numero solo per volumi finiti. Quindi una densità può superare 1 (è un'altezza, non una probabilità); solo la sua area totale vale 1. (Il concetto di area sotto una curva lo precisiamo nella lezione di analisi.)
La funzione di ripartizione (CDF) F(x) = P(X ≤ x) funziona per entrambe: è non decrescente, parte da 0 e arriva a 1.
from itertools import product
from fractions import Fraction
from collections import Counter

# PMF della somma di due dadi, esatta: si contano le coppie per ogni somma
conteggio = Counter(a + b for a, b in product(range(1, 7), repeat=2))
pmf = {x: Fraction(c, 36) for x, c in sorted(conteggio.items())}
print("PMF:", {x: str(p) for x, p in pmf.items()})
print("somma delle masse:", sum(pmf.values()))

cdf, acc = {}, Fraction(0)
for x, p in pmf.items():
    acc += p
    cdf[x] = acc
print("F(7) = P(X <= 7) =", cdf[7], "| F(12) =", cdf[12])
Output ottenuto:
PMF: {2: '1/36', 3: '1/18', 4: '1/12', 5: '1/9', 6: '5/36', 7: '1/6', 8: '5/36', 9: '1/9', 10: '1/12', 11: '1/18', 12: '1/36'}
somma delle masse: 1
F(7) = P(X <= 7) = 7/12 | F(12) = 1
Cosa fa il codice. Counter conta, per ogni valore della somma, in quante delle 36 coppie compare; dividendo per 36 si ottiene la PMF con frazioni esatte (lezione 3). La seconda parte costruisce la CDF accumulando le masse in ordine: F(7) = 21/36 = 7/12. Controlliamo che le masse sommino a 1 (primo assioma) e che F(12) = 1.
Valore atteso: il centro di massa
L'analogia: il punto di equilibrio
Metti sull'asse dei numeri dei pesi, ciascuno in x con massa p(x). Il punto in cui l'asse sta in equilibrio sulla punta di un dito è il valore atteso E[X] (o μ, «mu»):
E[X] = Σₓ x · p(x) (per le continue: ∫ x f(x) dx).
È una media pesata con le probabilità. Non è necessariamente un valore che X può assumere: il dado vale 3.5 in media, ma non esce mai 3.5.
La proprietà che semplifica tutto: la linearità
E[aX + b] = a·E[X] + b e E[X + Y] = E[X] + E[Y], anche quando X e Y non sono indipendenti.
Dimostrazione della somma (caso discreto). Con la distribuzione congiunta p(x, y): E[X + Y] = Σₓ Σᵧ (x + y) p(x, y) = Σₓ x Σᵧ p(x, y) + Σᵧ y Σₓ p(x, y). Le somme interne sono le distribuzioni marginali: Σᵧ p(x, y) = p_X(x) e Σₓ p(x, y) = p_Y(y). Quindi E[X + Y] = Σₓ x p_X(x) + Σᵧ y p_Y(y) = E[X] + E[Y]. ∎ Non è servita nessuna ipotesi di indipendenza.
Questa linearità permette un calcolo elegante: il valore atteso della somma di due dadi è 3.5 + 3.5 = 7, senza tabella.
E_dado = sum(Fraction(x, 6) for x in range(1, 7))
E_somma_pmf = sum(x * p for x, p in pmf.items())
print("E[dado]           =", E_dado, "=", float(E_dado))
print("E[somma] da PMF   =", E_somma_pmf)
print("E[somma] linearità=", 2 * E_dado)

# La linearità regge anche con dipendenza: numero di punti fissi di una permutazione casuale
import numpy as np
rng = np.random.default_rng(5)
n = 10
punti_fissi = [(rng.permutation(n) == np.arange(n)).sum() for _ in range(100_000)]
print("media simulata dei punti fissi:", round(float(np.mean(punti_fissi)), 3), "| teoria: 1")
Output ottenuto:
E[dado]           = 7/2 = 3.5
E[somma] da PMF   = 7
E[somma] linearità= 7
media simulata dei punti fissi: 1.002 | teoria: 1
Cosa fa il codice. La prima parte calcola E in due modi (dalla PMF e per linearità) e trova 7. La seconda è un esempio in cui la linearità brilla: una permutazione casuale di n elementi ha, in media, un solo punto fisso (elemento rimasto al suo posto), per qualunque n. Dimostrazione: sia Iᵢ l'indicatrice «l'elemento i resta al posto i». P(Iᵢ = 1) = 1/n e E[Iᵢ] = 1/n. I punti fissi sono ΣIᵢ, e per linearità E[ΣIᵢ] = n · (1/n) = 1. Le Iᵢ sono dipendenti tra loro, ma non importa. La simulazione conferma.
Varianza: la dispersione
Due ristoranti servono in media 100 coperti a sera: uno ne serve sempre tra 98 e 102, l'altro tra 20 e 180. Hanno lo stesso valore atteso, ma vite diverse. La varianza misura quanto una variabile si allontana in media dal suo valore atteso, al quadrato:
Var(X) = E[(X − μ)²].
Perché il quadrato? Gli scarti positivi e negativi si compenserebbero (la media degli scarti è sempre zero, per definizione di μ); elevando al quadrato diventano tutti positivi e si penalizzano di più gli scarti grandi. L'unità di misura però diventa il quadrato dell'originale (metri²), quindi si usa la deviazione standard σ = √Var(X), che torna all'unità di X.
La formula per il calcolo
Sviluppando il quadrato e usando la linearità:
Var(X) = E[X² − 2μX + μ²] = E[X²] − 2μ·E[X] + μ² = E[X²] − 2μ² + μ² = E[X²] − μ².
In parole: «media dei quadrati meno quadrato della media». Proprietà: Var(aX + b) = a²·Var(X) (traslare non cambia la dispersione, scalare per a la moltiplica per a²); se X e Y sono indipendenti, Var(X + Y) = Var(X) + Var(Y).
E2_dado = sum(Fraction(x * x, 6) for x in range(1, 7))
var_dado = E2_dado - E_dado ** 2
print("E[X^2] =", E2_dado, "| Var(dado) = E[X^2] - E[X]^2 =", var_dado, "=", round(float(var_dado), 4))

var_somma = sum((x - E_somma_pmf) ** 2 * p for x, p in pmf.items())
print("Var(somma di 2 dadi) =", var_somma, "| 2 * Var(dado) =", 2 * var_dado, "(indipendenza)")
print("deviazione standard del dado:", round(float(var_dado) ** 0.5, 4))
Output ottenuto:
E[X^2] = 91/6 | Var(dado) = E[X^2] - E[X]^2 = 35/12 = 2.9167
Var(somma di 2 dadi) = 35/6 | 2 * Var(dado) = 35/6 (indipendenza)
deviazione standard del dado: 1.7078
Cosa fa il codice. Calcola Var(dado) = 91/6 − (7/2)² = 35/12 dalla formula «media dei quadrati meno quadrato della media», poi la varianza della somma di due dadi direttamente dalla definizione, e mostra che coincide con 2·Var(dado): due dadi sono indipendenti, quindi le varianze si sommano (e non le deviazioni standard, che si sommano «in quadratura»).
Le distribuzioni notevoli
Bernoulli: la moneta
Un solo esperimento con due esiti: successo (1) con probabilità p, fallimento (0) con 1 − p. E[X] = p, Var(X) = p(1−p) (perché X² = X, quindi E[X²] = p e Var = p − p²). È il mattone di tutto.
Binomiale: il conteggio dei successi
Ripeti n prove di Bernoulli indipendenti: quanti successi k ottieni? Ogni sequenza con k successi e n − k fallimenti ha probabilità pᵏ(1−p)ⁿ⁻ᵏ (indipendenza: si moltiplica); le sequenze di quel tipo sono tante quante i modi di scegliere quali k prove hanno successo, cioè C(n, k) (lezione 2). Quindi
P(X = k) = C(n, k) · pᵏ · (1−p)ⁿ⁻ᵏ.
Per ottenere media e varianza non serve calcolare somme complicate: X è la somma di n Bernoulli indipendenti, quindi per linearità E[X] = np e, per indipendenza, Var(X) = np(1−p).
import math

def binomiale_pmf(k, n, p):
    return math.comb(n, k) * p ** k * (1 - p) ** (n - k)

n, p = 20, 0.3
pm = [binomiale_pmf(k, n, p) for k in range(n + 1)]
media = sum(k * q for k, q in enumerate(pm))
var = sum(k * k * q for k, q in enumerate(pm)) - media ** 2
print("somma delle masse:", round(sum(pm), 12))
print("media da PMF:", round(media, 6), "| n*p =", n * p)
print("varianza da PMF:", round(var, 6), "| n*p*(1-p) =", n * p * (1 - p))

rng = np.random.default_rng(7)
campione = rng.binomial(n, p, size=200_000)
print("simulazione: media", round(float(campione.mean()), 3), "| varianza", round(float(campione.var()), 3))
Output ottenuto:
somma delle masse: 1.0
media da PMF: 6.0 | n*p = 6.0
varianza da PMF: 4.2 | n*p*(1-p) = 4.199999999999999
simulazione: media 6.003 | varianza 4.17
Cosa fa il codice. Implementa la formula con math.comb, ne verifica la normalizzazione (somma 1) e calcola media e varianza dalla definizione, ritrovando np e np(1−p). L'ultima riga genera 200 000 binomiali con NumPy: media e varianza campionarie sono vicine ai valori teorici.
Poisson: gli eventi rari
Quanti clic arrivano in un minuto, quanti errori in una pagina? Immagina il minuto diviso in n istanti, in ciascuno un evento con probabilità p = λ/n (con λ il numero medio per minuto). Il conteggio è binomiale; per n grande e p piccolo, con λ = np fisso, C(n,k)pᵏ ≈ nᵏ/k! · (λ/n)ᵏ = λᵏ/k! e (1−λ/n)ⁿ⁻ᵏ → e⁻λ (un limite notevole che vedremo nella lezione di analisi). Il risultato è la distribuzione di Poisson:
P(X = k) = e^(−λ) · λᵏ / k!, con E[X] = Var(X) = λ.
lam = 3.0
n_grande, p_piccolo = 1000, lam / 1000
print(" k | binomiale(1000, 0.003) | Poisson(3)")
for k in range(0, 8):
    b = binomiale_pmf(k, n_grande, p_piccolo)
    po = math.exp(-lam) * lam ** k / math.factorial(k)
    print(f"{k:>2} | {b:22.5f} | {po:10.5f}")
Output ottenuto:
 k | binomiale(1000, 0.003) | Poisson(3)
 0 |                0.04956 |    0.04979
 1 |                0.14914 |    0.14936
 2 |                0.22415 |    0.22404
 3 |                0.22438 |    0.22404
 4 |                0.16828 |    0.16803
 5 |                0.10087 |    0.10082
 6 |                0.05033 |    0.05041
 7 |                0.02151 |    0.02160
Cosa fa il codice. Confronta la PMF binomiale con n = 1000 e p = 0.003 e la PMF di Poisson con λ = 3: coincidono alla terza o quarta cifra. La Poisson è l'approssimazione giusta per conteggi di eventi rari in un intervallo; ha la caratteristica che media e varianza sono uguali, un controllo rapido per capire se dei conteggi sono davvero «poissoniani» (se la varianza è molto più grande della media, c'è sovradispersione e serve altro).
Uniforme: nessuna preferenza
Densità costante su [a, b]: f(x) = 1/(b−a). E = (a+b)/2, Var = (b−a)²/12. È la distribuzione dei generatori di numeri casuali di base (rng.random()), da cui si costruiscono tutte le altre.
Esponenziale: il tempo di attesa
Se gli eventi arrivano con intensità λ per unità di tempo, il tempo fino al prossimo ha densità f(x) = λe^(−λx) per x ≥ 0, con E = 1/λ e Var = 1/λ². Ha la proprietà senza memoria: P(X > s + t | X > s) = P(X > t). Aver già aspettato s non cambia quanto resta da aspettare. Dimostrazione: P(X > x) = e^(−λx), quindi P(X > s+t | X > s) = P(X > s+t)/P(X > s) = e^(−λ(s+t))/e^(−λs) = e^(−λt). ∎
rng = np.random.default_rng(3)
tempi = rng.exponential(scale=1 / 0.5, size=400_000)        # λ = 0.5, media teorica 2
print("media:", round(float(tempi.mean()), 3), "| teoria 1/λ =", 2.0)
s, t = 1.5, 2.0
cond = (tempi[tempi > s] > s + t).mean()
print(f"P(X > {s + t} | X > {s}) simulata = {cond:.4f} | P(X > {t}) = {(tempi > t).mean():.4f} | teoria e^(-λt) = {math.exp(-0.5 * t):.4f}")
Output ottenuto:
media: 2.005 | teoria 1/λ = 2.0
P(X > 3.5 | X > 1.5) simulata = 0.3677 | P(X > 2.0) = 0.3694 | teoria e^(-λt) = 0.3679
Cosa fa il codice. Genera tempi esponenziali con λ = 0.5 (media 2). Poi calcola la probabilità condizionata di superare s + t dato che si è già superato s: filtrando i tempi oltre s (la «stanza ristretta» della lezione 3) e contando quanti superano s + t. Il valore coincide con la probabilità incondizionata di superare t: l'esponenziale non ricorda.
Normale: la campana
N(μ, σ²) ha densità
f(x) = (1 / (σ√(2π))) · exp(−(x − μ)² / (2σ²)).
Ha forma simmetrica, centrata in μ, larga come σ. Qualunque normale si riporta alla normale standard N(0, 1) con la standardizzazione Z = (X − μ)/σ (la stessa operazione della lezione su NumPy). Proprietà memorabile (regola 68-95-99.7): la probabilità di cadere entro kσ dalla media è erf(k/√2), con erf la funzione degli errori.
for k in (1, 2, 3):
    print(f"P(|Z| <= {k}) = {math.erf(k / math.sqrt(2)):.4f}")
print("valore esatto 1.96:", round(math.erf(1.96 / math.sqrt(2)), 4), "(il 95 % usato negli intervalli di confidenza)")

from scipy import stats
print("controllo con SciPy:", round(stats.norm.cdf(2) - stats.norm.cdf(-2), 4))
Output ottenuto:
P(|Z| <= 1) = 0.6827
P(|Z| <= 2) = 0.9545
P(|Z| <= 3) = 0.9973
valore esatto 1.96: 0.95 (il 95 % usato negli intervalli di confidenza)
controllo con SciPy: 0.9545
Cosa fa il codice. math.erf(k/√2) dà la probabilità entro ±kσ: 0.6827, 0.9545, 0.9973. 1.96 è il valore che lascia il 2.5% in ciascuna coda (95% al centro): lo ritroverai negli intervalli di confidenza. L'ultima riga lo conferma con scipy.stats.norm, la libreria di riferimento per le distribuzioni.
Perché è così importante. Non perché «la natura sia normale», ma per il teorema del limite centrale, che vediamo tra poco.
Chebyshev e la legge dei grandi numeri
Markov e Chebyshev
Disuguaglianza di Markov. Se Y ≥ 0 e a > 0, allora P(Y ≥ a) ≤ E[Y] / a. Dimostrazione: E[Y] = E[Y·1{Y<a}] + E[Y·1{Y≥a}] ≥ 0 + a·P(Y ≥ a), perché sull'evento Y ≥ a il valore di Y è almeno a. Dividendo per a si ottiene la tesi. ∎
Disuguaglianza di Chebyshev. Applicando Markov a Y = (X − μ)² con a = (kσ)²: P(|X − μ| ≥ kσ) = P((X−μ)² ≥ k²σ²) ≤ σ²/(k²σ²) = 1/k². In parole: qualunque distribuzione con varianza finita ha al più 1/k² di probabilità oltre k deviazioni standard (al più 25% oltre 2σ, 11% oltre 3σ). È un limite grossolano ma valido per tutte.
La legge dei grandi numeri
Sia X̄ₙ la media di n osservazioni indipendenti con la stessa media μ e varianza σ². Allora E[X̄ₙ] = μ e Var(X̄ₙ) = σ²/n (le varianze si sommano, poi il fattore 1/n² divide per n). Per Chebyshev:
P(|X̄ₙ − μ| ≥ ε) ≤ σ² / (n ε²) → 0 per n → ∞.
La media campionaria si avvicina alla media vera, con una dispersione che scende come σ/√n: per dimezzare l'errore servono quattro volte i dati.
rng = np.random.default_rng(11)
mu, sigma = 2.0, 2.0                                   # esponenziale con media 2 e deviazione standard 2
eps = 0.25
print("   n | P(|media - μ| >= 0.25) simulata | limite di Chebyshev | errore tipico σ/√n")
for n in (10, 100, 1_000, 10_000):
    medie = rng.exponential(scale=mu, size=(5_000, n)).mean(axis=1)
    p_sim = (np.abs(medie - mu) >= eps).mean()
    bound = min(1.0, sigma ** 2 / (n * eps ** 2))
    print(f"{n:>5} | {p_sim:31.4f} | {bound:19.4f} | {sigma / math.sqrt(n):.4f}")
Output ottenuto:
   n | P(|media - μ| >= 0.25) simulata | limite di Chebyshev | errore tipico σ/√n
   10 |                          0.6934 |              1.0000 | 0.6325
  100 |                          0.2168 |              0.6400 | 0.2000
 1000 |                          0.0002 |              0.0640 | 0.0632
10000 |                          0.0000 |              0.0064 | 0.0200
Cosa fa il codice. Per ciascun n genera 5000 campioni di n tempi esponenziali e ne calcola la media (una riga = un campione; axis=1 media sulle colonne). Poi stima la probabilità che la media sbagli di almeno 0.25 e la confronta con il limite di Chebyshev. Entrambi vanno a zero al crescere di n; il limite è un maggiorante molto prudente (a n = 1000 la probabilità vera è 0.0002, il limite vale ancora 0.064).
Il teorema del limite centrale
La legge dei grandi numeri dice dove va la media campionaria; il teorema del limite centrale (TLC) dice come si distribuisce attorno a μ:
Se X₁, …, Xₙ sono indipendenti con la stessa distribuzione (media μ, varianza finita σ²), la media standardizzata (X̄ₙ − μ)/(σ/√n) tende, per n grande, a una N(0, 1), qualunque sia la forma di partenza.
L'enunciato è sorprendente: dati asimmetrici, a code lunghe da un lato, hanno medie che si distribuiscono a campana. La dimostrazione completa richiede strumenti oltre questo corso (funzioni caratteristiche); verifichiamolo sperimentalmente su una distribuzione molto asimmetrica, l'esponenziale.
import matplotlib.pyplot as plt
from scipy.stats import skew

plt.rcParams["svg.hashsalt"] = "mle"
rng = np.random.default_rng(21)
mu, sigma = 1.0, 1.0                                   # esponenziale con λ = 1

fig, assi = plt.subplots(1, 4, figsize=(11, 2.6))
for ax, n in zip(assi, (1, 2, 10, 50)):
    medie = rng.exponential(scale=mu, size=(50_000, n)).mean(axis=1)
    z = (medie - mu) / (sigma / math.sqrt(n))
    ax.hist(z, bins=60, range=(-4, 5), density=True, color="#0072B2")
    x = np.linspace(-4, 5, 200)
    ax.plot(x, np.exp(-x ** 2 / 2) / math.sqrt(2 * math.pi), color="#D55E00")
    ax.set_title(f"n = {n}")
    print(f"n = {n:>2}: asimmetria (skewness) = {skew(z):6.3f} | P(|Z| <= 1.96) = {(np.abs(z) <= 1.96).mean():.4f}")
fig.tight_layout()
fig.savefig("tlc-esponenziale.svg", metadata={"Date": None})
plt.close(fig)
Output ottenuto:
n =  1: asimmetria (skewness) =  2.015 | P(|Z| <= 1.96) = 0.9469
n =  2: asimmetria (skewness) =  1.371 | P(|Z| <= 1.96) = 0.9498
n = 10: asimmetria (skewness) =  0.617 | P(|Z| <= 1.96) = 0.9546
n = 50: asimmetria (skewness) =  0.285 | P(|Z| <= 1.96) = 0.9511
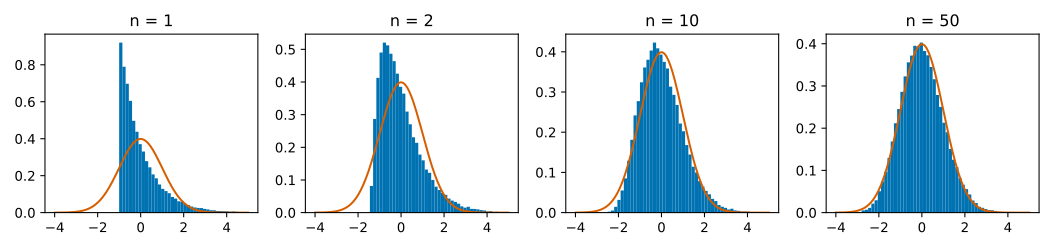
Cosa fa il codice. Per n = 1, 2, 10, 50 genera 50 000 campioni di n esponenziali, ne calcola la media e la standardizza con la formula del TLC (z). L'istogramma (barre blu) si confronta con la densità normale standard (linea arancio). Per n = 1 la forma è quella esponenziale, fortemente asimmetrica (asimmetria 2); con n = 50 è quasi una campana, con asimmetria 0.285. La frazione di valori entro ±1.96 vale già 0.947 per n = 1 e 0.951 per n = 50: la copertura del 95% è una proprietà debole, che non basta a dichiarare normale una distribuzione, e per questo conta guardare anche l'asimmetria e l'istogramma. L'asimmetria (skewness) è un numero che misura quanto una distribuzione si sbilancia da una parte: 0 per una simmetrica.
Trade-off e limiti. Il TLC è un teorema asintotico: dice come va per n → ∞, non quanto grande deve essere n. Per distribuzioni quasi simmetriche bastano poche decine di osservazioni; per distribuzioni molto asimmetriche o con code pesanti possono servirne molte di più. È la giustificazione di ciò che farai nella lezione di statistica: intervalli di confidenza e test basati sulla normale.
Quando non funziona: le code pesanti
Il TLC e la legge dei grandi numeri richiedono una media (e una varianza) finite. La distribuzione di Cauchy (il rapporto tra due normali standard) è un esempio in cui non esistono: le code sono così pesanti che i valori estremi dominano ogni media.
rng = np.random.default_rng(2)
cauchy = rng.standard_cauchy(size=1_000_000)
normale = rng.standard_normal(size=1_000_000)
print("   n | media campionaria Cauchy | media campionaria normale")
for n in (100, 1_000, 10_000, 100_000, 1_000_000):
    print(f"{n:>7} | {cauchy[:n].mean():24.4f} | {normale[:n].mean():24.4f}")
print("valore assoluto massimo osservato nella Cauchy:", round(float(np.abs(cauchy).max()), 1))
Output ottenuto:
   n | media campionaria Cauchy | media campionaria normale
    100 |                  -2.1549 |                  -0.0755
   1000 |                  -1.8108 |                  -0.0322
  10000 |                   0.2042 |                  -0.0100
 100000 |                   0.6581 |                   0.0006
1000000 |                  -0.3914 |                   0.0016
valore assoluto massimo osservato nella Cauchy: 159848.9
Cosa fa il codice. Calcola la media dei primi n valori di due campioni. Quella normale tende a zero come previsto dalla legge dei grandi numeri (da −0.08 con 100 valori a 0.0016 con un milione, in modo irregolare perché la media è essa stessa casuale). Quella di Cauchy non converge: oscilla fra circa −2 e +1 e cambia segno in modo irregolare anche con un milione di valori, perché ogni tanto compare un valore gigantesco (qui quasi 160 000) che trascina la media. È un fatto noto che la media di n Cauchy standard è essa stessa una Cauchy standard: fare la media non concentra nulla. Aggiungere dati non aiuta.
Lezione pratica. Per dati con code pesanti (importi, tempi di risposta, dimensioni) la media può essere un riassunto instabile: si usano la mediana e i quantili, e si controlla sempre l'istogramma (lezione sulla visualizzazione). Non fidarti di una media senza aver guardato le code.
Covarianza e correlazione
Per due variabili la covarianza misura se tendono a muoversi insieme:
Cov(X, Y) = E[(X − μ_X)(Y − μ_Y)] = E[XY] − E[X]·E[Y].
Positiva: crescono insieme; negativa: una cresce quando l'altra cala. Dipende dalle unità, quindi si normalizza nella correlazione ρ = Cov(X, Y)/(σ_X σ_Y), sempre tra −1 e +1. Se X e Y sono indipendenti, E[XY] = E[X]E[Y] e Cov = 0. Il contrario è falso: correlazione zero non significa indipendenza, perché misura solo la relazione lineare.
rng = np.random.default_rng(8)
x = rng.normal(size=200_000)
y = x ** 2                                            # y è funzione di x, quindi dipendente
print("corr(X, X^2) =", round(float(np.corrcoef(x, y)[0, 1]), 4), "(vicina a zero, ma y = x^2 !)")

z = 0.8 * x + 0.6 * rng.normal(size=x.size)
print("corr(X, 0.8X + rumore) =", round(float(np.corrcoef(x, z)[0, 1]), 4), "| teoria 0.8")
Output ottenuto:
corr(X, X^2) = 0.0005 (vicina a zero, ma y = x^2 !)
corr(X, 0.8X + rumore) = 0.8012 | teoria 0.8
Cosa fa il codice. La prima coppia mostra una dipendenza perfetta (y è determinata da x) con correlazione quasi nulla: la relazione è una parabola, non una retta, e il segno di x si compensa. La seconda coppia costruisce una relazione lineare con rumore; il coefficiente 0.8 è proprio la correlazione teorica, perché 0.8² + 0.6² = 1 mantiene la varianza di z uguale a 1.
Errori tipici (sintomo, causa, rimedio)
- «Media = valore tipico». Con distribuzioni asimmetriche o a code pesanti la media è lontana dal caso tipico. Rimedio: mediana, quantili, istogramma.
- Sommare deviazioni standard invece di varianze.
σ_{X+Y} = √(σ_X² + σ_Y²)per indipendenti, nonσ_X + σ_Y. - Usare la binomiale senza indipendenza. Se le prove dipendono (clienti della stessa famiglia), la varianza non è
np(1−p). - Confondere densità e probabilità. Una densità può valere 3 senza violare nulla: l'area conta.
- Applicare il TLC a campioni piccoli o a code pesanti. Rimedio: simulare, o usare il bootstrap.
- Correlazione zero = indipendenza. Falso (parabola).
- Dimenticare di fissare il seed. I numeri cambiano a ogni esecuzione.
Il filo comune è che ogni riassunto numerico (media, deviazione standard, correlazione) nasconde una forma. Gli errori sulla media, sul TLC e sulla correlazione nascono dal guardare il numero senza guardare la distribuzione che lo ha prodotto; quelli sulla somma delle deviazioni standard e sulla densità sono errori di formula, e si evitano scrivendo i calcoli con le unità di misura accanto; quello sulla binomiale è una ipotesi (l'indipendenza) data per scontata.
Come lavorare nella pratica
Scegli la distribuzione dal meccanismo che genera i dati: conteggio di successi in prove indipendenti, binomiale; eventi rari in un intervallo, Poisson; tempi di attesa, esponenziale; somme di molti piccoli contributi, normale. Verifica con una simulazione ogni formula che ti serve, riporta sempre media e deviazione standard insieme alla dimensione del campione n, guarda il grafico prima di scegliere un riassunto e, per CDF, quantili e campionamento, usa scipy.stats invece delle formule scritte a mano.
Il lessico si riassume così. La variabile aleatoria associa un numero a ogni esito; la PMF dà la massa delle discrete, la densità descrive le continue e la CDF vale per entrambe. Il valore atteso è la media pesata con le probabilità, la varianza la dispersione al quadrato attorno alla media e la deviazione standard la sua radice. La standardizzazione (X − μ)/σ porta qualunque variabile a media 0 e deviazione standard 1; asintotico significa valido al limite n → ∞; le code pesanti sono distribuzioni in cui i valori estremi hanno probabilità non trascurabile.
Mini-progetto
- Simula 100 000 volte il numero di teste in 30 lanci di una moneta con
p = 0.4. Confronta media, varianza e frequenze osservate con la PMF binomiale. - Con
scipy.stats.poisson, verifica che perλ = 4la probabilità di ottenere almeno 8 eventi è pari a1 − F(7). - Verifica per simulazione la legge dei grandi numeri su un dado: disegna la media dei primi
nlanci controne aggiungi la fascia3.5 ± 1.708/√n(la deviazione standard del dado è 1.708).
I tre punti si somigliano: confrontano un numero teorico, dimostrato nella lezione, con una stima per simulazione. Se i due valori non coincidono entro il rumore atteso (dell'ordine di σ/√n), il primo sospetto cade sul codice e non sul teorema; il terzo punto è sviluppato per intero nella sfida svolta qui sotto.
Una sfida svolta: la legge dei grandi numeri su un dado
Il mini-progetto chiedeva di verificare la legge dei grandi numeri su un dado, con una fascia di incertezza attorno alla media. La media vera è 3.5 e la deviazione standard √(35/12) ≈ 1.708 (calcolata in questa lezione); la media di n lanci ha quindi deviazione standard 1.708/√n. Se la legge e il TLC funzionano, circa il 95% delle medie campionarie dovrebbe cadere dentro 3.5 ± 1.96·1.708/√n.
import numpy as np

rng = np.random.default_rng(13)
sigma = np.sqrt(35 / 12)
lanci = rng.integers(1, 7, size=(5_000, 10_000))                 # 5000 serie indipendenti da 10 000 lanci
cumulata = np.cumsum(lanci, axis=1) / np.arange(1, lanci.shape[1] + 1)

print(f"{'n':>6} {'media delle medie':>18} {'dev. std osservata':>19} {'sigma/sqrt(n)':>14} {'quota dentro 3.5±1.96·σ/√n':>28}")
for n in (10, 100, 1_000, 10_000):
    medie_n = cumulata[:, n - 1]
    teorica = sigma / np.sqrt(n)
    dentro = (np.abs(medie_n - 3.5) <= 1.96 * teorica).mean()
    print(f"{n:>6} {medie_n.mean():>18.4f} {medie_n.std():>19.4f} {teorica:>14.4f} {dentro:>28.3f}")
Output ottenuto:
     n  media delle medie  dev. std osservata  sigma/sqrt(n)   quota dentro 3.5±1.96·σ/√n
    10             3.4934              0.5458         0.5401                        0.952
   100             3.4982              0.1726         0.1708                        0.949
  1000             3.4997              0.0544         0.0540                        0.949
 10000             3.5001              0.0172         0.0171                        0.947
Come leggere il codice. lanci è una matrice 5000 × 10 000: ogni riga è una serie di lanci di un dado onesto (rng.integers(1, 7, ...) estrae interi da 1 a 6). np.cumsum(..., axis=1) calcola, per ogni serie, la somma progressiva dei lanci; dividendo per 1, 2, 3, … (il numero di lanci fatti fino a quel punto) si ottiene la media corrente: la colonna n − 1 contiene la media dei primi n lanci di ciascuna serie. Per quattro valori di n si confrontano tre cose: la media delle 5000 medie (che deve stare vicino a 3.5), la deviazione standard osservata delle medie (che deve seguire σ/√n: si divide per √10 ≈ 3.16 ogni volta che n viene moltiplicato per 10) e la quota di medie dentro la fascia a due sigma, vicina al 95% previsto dal TLC. Il fatto che le due colonne dev. std osservata e sigma/sqrt(n) coincidano è la verifica sperimentale di Var(X̄) = σ²/n.
Challenge
- Easy. Calcola a mano
E[X]eVar(X)per una variabile che vale 0, 1, 2 con probabilità 0.5, 0.3, 0.2 e verifica in codice. - Medium. Dimostra che per una Poisson
E[X] = λ:Σ k e^(−λ) λᵏ/k! = λ Σ e^(−λ) λ^(k−1)/(k−1)! = λ. - Hard. Dimostra
Var(aX + b) = a²Var(X)e verifica con 100 000 campioni normali cona = 3,b = 5. - Expert. Dimostra che per due variabili qualunque
Var(X + Y) = Var(X) + Var(Y) + 2Cov(X, Y), e usa il risultato per spiegare perché la varianza della media dinvariabili correlate non scende comeσ²/n. - Enterprise. Prendi la serie dei tempi di risposta di un servizio della tua organizzazione: l'esponenziale è un buon modello? Confronta media e mediana, la proprietà senza memoria, e dichiara se la media è un riassunto sicuro.
Le prime tre sfide sono calcoli guidati sulle formule della lezione, la quarta mette alla prova la covarianza, la quinta chiede un giudizio su dati veri: se la mediana dei tuoi tempi di risposta è molto più bassa della media, la coda lunga che hai visto con la Cauchy sta già lavorando nei tuoi dati.
Che cosa sai fare adesso
Sai associare un numero a ogni esito, calcolare valore atteso e varianza con la linearità e con la formula «media dei quadrati meno quadrato della media», scegliere fra binomiale, Poisson, esponenziale e normale in base al meccanismo, e verificare per simulazione la legge dei grandi numeri e il teorema del limite centrale. Sai anche riconoscere quando non valgono: con una Cauchy la media non converge, e fare la media non concentra nulla. Il passo successivo è la statistica, che percorre la strada inversa dai dati ai parametri, con gli integrali delle densità spiegati in Analisi matematica 2.
Nella stessa serie trovi anche: 29 - Campionamento e metodi Monte Carlo: stimare quello che non si riesce a calcolare (che richiama questa lezione).
Fonti
- J. K. Blitzstein, J. Hwang, Introduction to Probability, 2ª ed., CRC Press, 2019 - variabili aleatorie, linearità, distribuzioni; L. Wasserman, All of Statistics, Springer, 2004, capp. 1-5 - Chebyshev, legge dei grandi numeri, TLC (libri a stampa, non consultati online)
- J. Bernoulli, Ars Conjectandi, 1713 - legge dei grandi numeri; P. L. Chebyshev, 1867 - la disuguaglianza; S.-D. Poisson, Recherches sur la probabilité des jugements, 1837 - la distribuzione di Poisson (citazioni storiche, non consultate)
- NIST/SEMATECH e-Handbook of Statistical Methods: Cauchy Distribution - la densità standard e l'affermazione che media e deviazione standard non sono definite, consultata il 2026-11-12
- SciPy: scipy.stats -
normepoissoncon CDF e quantili usati per i controlli, consultata il 2026-11-12 - NumPy: Random Generator -
default_rngcon seme fisso e i metodi di campionamento delle simulazioni, consultata il 2026-11-12
Commenti
Caricamento commenti...
Accedi per commentare