Hai calcolato media, deviazione standard e correlazione di un campione, e i numeri sembrano ragionevoli. La domanda è quanto puoi fidarti di loro. Un numero riassuntivo comprime decine o migliaia di valori in uno solo, e quello che butta via dipende dai dati: due campioni molto diversi possono produrre lo stesso riassunto. Un grafico restituisce l'informazione persa, ed è per questo che si fa prima di calcolare e di modellare, non a fine analisi come decorazione. In questa lezione del modulo «Python per i dati» costruisci i grafici con Matplotlib in modo esplicito (Figure e Axes), scegli il tipo di grafico in base alla domanda, regoli i bin di un istogramma con un criterio invece che a occhio, misuri quanto inganna un asse troncato e vedi con quattro piccoli insiemi di dati perché le statistiche da sole non bastano.
Servono Python 3, NumPy e Matplotlib (pip install numpy matplotlib in un ambiente virtuale). I listati sono stati eseguiti con Python 3.14.4, NumPy 2.3.5 e Matplotlib 3.10.7; dove una funzione cambia da una versione all'altra lo dico. Se arrivi dalla lezione su Pandas, ricorda che DataFrame.plot è un involucro attorno a Matplotlib: quello che impari qui vale anche per i grafici che nascono da una tabella.
L'anatomia di Matplotlib
La cornice e il quadro
La Figure è la tela intera, la cornice: l'oggetto che salvi in un file. Dentro puoi appendere uno o più quadri, e ciascuno è un Axes. Il nome è al plurale ma indica un riquadro con i suoi assi, non «gli assi». La riga con i numeri su un lato è un Axis, e tutto ciò che viene disegnato (linee, punti, testi) è un Artist. Confondere Axes con Axis è l'errore di lessico più comune, e fa leggere male la documentazione.
Matplotlib offre due modi di usarlo. Il primo, a stato globale, passa dalle funzioni di pyplot come plt.plot(...) e plt.title(...): lavorano su «la figura corrente», e in un notebook per un grafico veloce vanno benissimo; con più figure aperte però si perde il filo di quale sia la corrente. Il secondo è l'interfaccia a oggetti: chiedi fig, ax = plt.subplots() e poi chiami i metodi di ax, così sai sempre su quale riquadro stai disegnando. È più prolisso e più esplicito, e la guida rapida di Matplotlib descrive i due stili come le due strade possibili, rimandando alla pagina sulle API per i compromessi. In questa lezione usiamo il secondo, perché il codice che deve durare e passare da una funzione all'altra ha bisogno di sapere a quale ax sta scrivendo.
Il listato disegna seno e coseno sullo stesso riquadro. Le righe che meritano attenzione sono due: matplotlib.use("Agg"), che sceglie il backend (il motore di disegno) non interattivo, quello che scrive solo su file e funziona anche su un server senza schermo; e plt.rcParams["svg.hashsalt"] insieme a metadata={"Date": None}, che servono solo a rendere il file SVG identico byte per byte a ogni esecuzione (altrimenti Matplotlib vi incorpora un identificatore casuale e la data). Nel codice di tutti i giorni non ti servono.
import numpy as np
import matplotlib
matplotlib.use("Agg")                       # backend non interattivo: scrive solo su file
import matplotlib.pyplot as plt

plt.rcParams["svg.hashsalt"] = "mle"           # SVG riproducibili byte per byte
x = np.linspace(0, 2 * np.pi, 200)

fig, ax = plt.subplots(figsize=(6, 3))
ax.plot(x, np.sin(x), label="sin(x)")
ax.plot(x, np.cos(x), label="cos(x)", linestyle="--")
ax.set_xlabel("x (radianti)")
ax.set_ylabel("valore")
ax.set_title("Due funzioni sullo stesso riquadro")
ax.legend()
fig.tight_layout()
fig.savefig("seno-coseno.svg", metadata={"Date": None})
plt.close(fig)
print("figura salvata:", type(fig).__name__, "| asse:", type(ax).__name__, "| backend:", matplotlib.get_backend())
Uscita ottenuta (Python 3.14.4, NumPy 2.3.5, Matplotlib 3.10.7; il listato è stato eseguito due volte con uscita identica):
figura salvata: Figure | asse: Axes | backend: Agg
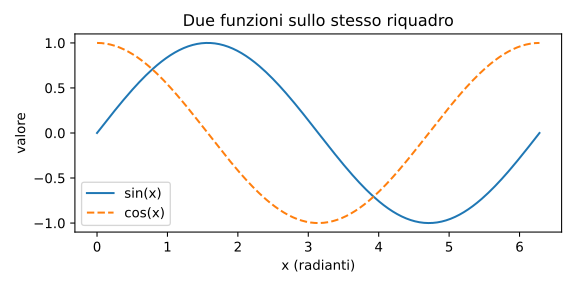
L'uscita conferma i tipi: plt.subplots restituisce un oggetto Figure e un Axes, e il backend in uso è Agg. Senza la riga matplotlib.use, sulla mia macchina il backend scelto in automatico era qtagg, uno di quelli interattivi: è una delle ragioni per cui lo stesso script può comportarsi diversamente su due macchine. Altre tre note. plt.close(fig) libera la memoria della figura: in un ciclo che ne crea centinaia, dimenticarlo la accumula, e Matplotlib segnala il problema oltre le 20 figure aperte (figure.max_open_warning vale 20, misurato nell'ultimo listato della lezione). savefig sceglie il formato dall'estensione: un formato vettoriale (svg, pdf) resta nitido a qualsiasi ingrandimento, mentre png con un dpi= adeguato va meglio per figure con milioni di punti. Infine, scrivere su file è scrivere su file: se il percorso non esiste o la cartella non è scrivibile ottieni gli stessi errori che incontri con qualsiasi altro file, descritti nella lezione su funzioni, file, eccezioni e oggetti.
Quale grafico per quale domanda
La regola di fondo, valida per qualsiasi libreria, è prima la domanda, poi il grafico. La tabella accoppia le cinque domande che si incontrano di più con il grafico che le serve meglio e con il motivo.
| La domanda | Il grafico | Perché |
|---|---|---|
| Come sono distribuiti i valori? | istogramma, boxplot, funzione di ripartizione empirica | mostra forma, centro, dispersione, code, picchi |
| C'è una relazione tra due numeri? | diagramma a dispersione (scatter) | ogni punto è un caso; si vede la nuvola |
| Come cambia nel tempo? | grafico a linee | la linea comunica continuità e direzione |
| Quale categoria è più grande? | barre (orizzontali se le etichette sono lunghe) | la lunghezza da una base comune si confronta con precisione |
| Quanto pesa ciascuna parte? | barre impilate o semplici barre ordinate | i settori circolari si confrontano male |
Dietro la tabella c'è un risultato sperimentale: Cleveland e McGill (1984) misurarono con quanta accuratezza le persone leggono diversi elementi grafici e trovarono che la posizione lungo una scala comune (punti, barre dalla stessa base) si giudica meglio dell'angolo, dell'area o del colore. Per questo le barre battono le torte quando il compito è confrontare. Il compromesso è sempre lo stesso: un grafico più ricco, con il colore per una terza variabile e la dimensione del punto per una quarta, trasmette più informazione ma costa più lavoro di lettura. Ogni elemento visivo in più deve rispondere a una domanda in più; altrimenti toglilo.
Lo stesso campione con tre grafici
L'istogramma non è l'unico modo di guardare una distribuzione, e per dati con code lunghe o valori anomali non è il migliore. Il prossimo listato genera 500 tempi di risposta da una distribuzione log-normale (che ha una coda a destra, come i tempi veri) e ci aggiunge tre valori anomali, 14, 17.5 e 22 secondi. Poi li disegna con istogramma, boxplot (scatola e baffi) e funzione di ripartizione empirica, ECDF. Il seme del generatore (default_rng(5)) fissa il campione: due esecuzioni danno gli stessi numeri. Una nota di versione: nel boxplot l'orientamento si sceglie con orientation="horizontal", introdotto in Matplotlib 3.10; il vecchio argomento vert=False è indicato come deprecato dalla 3.11 nella documentazione corrente, quindi non lo uso.
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

plt.rcParams["svg.hashsalt"] = "mle"
rng = np.random.default_rng(5)
tempi = np.concatenate([rng.lognormal(mean=0.0, sigma=0.6, size=500), [14.0, 17.5, 22.0]])

q1, mediana, q3 = np.percentile(tempi, [25, 50, 75])
print(f"media = {tempi.mean():.2f} | mediana = {mediana:.2f} | scarto interquartile = {q3 - q1:.2f} | massimo = {tempi.max():.1f}")

fig, assi = plt.subplots(1, 3, figsize=(11, 3))
assi[0].hist(tempi, bins=40, color="#0072B2", edgecolor="white")
assi[0].set_title("istogramma")
assi[1].boxplot(tempi, orientation="horizontal", widths=0.5)
assi[1].set_title("boxplot")
ordinati = np.sort(tempi)
assi[2].step(ordinati, np.arange(1, ordinati.size + 1) / ordinati.size, color="#D55E00")
assi[2].set_title("ECDF")
for ax in assi:
    ax.set_xlabel("tempo di risposta (s)")
fig.tight_layout()
fig.savefig("tre-viste.svg", metadata={"Date": None})
plt.close(fig)
Uscita ottenuta (Python 3.14.4, NumPy 2.3.5, Matplotlib 3.10.7; il listato è stato eseguito due volte con uscita identica):
media = 1.28 | mediana = 0.99 | scarto interquartile = 0.86 | massimo = 22.0
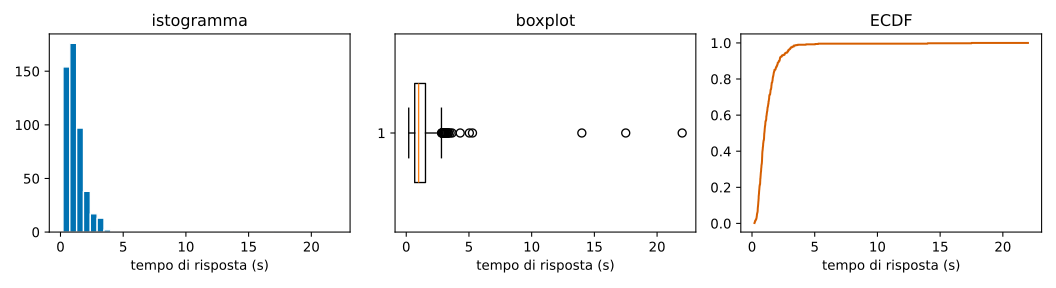
I numeri stampati dicono già molto: la media (1.28) supera di quasi tre decimi la mediana (0.99) perché i tre anomali la trascinano verso l'alto, mentre lo scarto interquartile, la larghezza del 50% centrale dei dati, resta 0.86. Nell'istogramma la forma c'è, ma i tre anomali sono quasi invisibili: barre alte un solo elemento, lontanissime dal resto. Il boxplot disegna la scatola tra primo e terzo quartile con una linea sulla mediana; secondo la documentazione di Axes.boxplot i baffi arrivano fino al dato più lontano che stia entro 1.5 volte lo scarto interquartile dalla scatola, e i punti oltre i baffi sono disegnati uno per uno: qui gli anomali saltano all'occhio. L'ECDF (per ogni valore x, la frazione di dati minori o uguali a x) non dipende da alcuna scelta di bin e si legge in verticale sui quantili: dove la curva incrocia 0.5 c'è la mediana. Tre strumenti, tre domande: la forma, gli anomali, i quantili senza arbitrarietà.
Istogrammi: quanti bin?
Un istogramma divide l'asse in intervalli di uguale larghezza, i bin, e conta quanti dati cadono in ciascuno. L'unico parametro che conta è la larghezza, e la scelta è un compromesso. Con bin troppo larghi tutto si schiaccia e le strutture spariscono: è la distorsione (bias). Con bin troppo stretti ogni barra contiene pochi dati, il profilo diventa dentellato e inventa picchi che non esistono: è il rumore, cioè la varianza. È lo stesso compromesso tra semplificare troppo e inseguire il rumore che ritrovi in tutto il machine learning, per esempio quando scegli la complessità di un modello.
Per non andare a occhio esistono regole che fissano il numero o la larghezza dei bin, e NumPy le implementa tutte in numpy.histogram_bin_edges (argomento bins con il nome del metodo). Con n dati: la regola di Sturges (1926) usa k = ⌈log₂ n⌉ + 1 bin e tiene conto solo di n; quella di Scott (1979) usa la larghezza h = 3.49 · σ · n-1/3, con σ deviazione standard; quella di Freedman e Diaconis (1981) usa h = 2 · IQR · n-1/3, con IQR scarto interquartile. Il fattore n-1/3 viene dal minimizzare l'errore quadratico medio integrato dell'istogramma come stima della densità, che somma un termine di distorsione (cresce con la larghezza) e uno di varianza (cala con la larghezza); la larghezza ottima li bilancia. La costante 3.49 di Scott coincide con il (24·√π)1/3 che trovi nel codice di NumPy, e quello di Sturges, nell'implementazione di NumPy, è la larghezza «intervallo dei dati diviso per log₂ n + 1» (l'ho letta nel sorgente della versione installata).
Un'opzione da conoscere è "auto": secondo la documentazione prende la larghezza minima fra quella di Sturges e quella di Freedman-Diaconis. Quando non indichi nulla, np.histogram usa invece 10 bin (misurato in coda alla lezione).
Vediamo il compromesso su dati con due gruppi: 300 punti attorno a 0 e 300 attorno a 4, generati con un seme fisso. Il listato stampa il numero di bin scelto da ciascun metodo e poi disegna lo stesso campione con 2, 11 e 200 bin.
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

plt.rcParams["svg.hashsalt"] = "mle"
rng = np.random.default_rng(3)
dati = np.concatenate([rng.normal(0, 1, 300), rng.normal(4, 1, 300)])

for metodo in ("sturges", "fd", "scott"):
    k = len(np.histogram_bin_edges(dati, bins=metodo)) - 1
    print(f"{metodo:8s}: {k} bin")

fig, assi = plt.subplots(1, 3, figsize=(10, 2.8), sharey=False)
for ax, k in zip(assi, (2, 11, 200)):
    ax.hist(dati, bins=k, color="#0072B2", edgecolor="white")
    ax.set_title(f"{k} bin")
    ax.set_xlabel("valore")
assi[0].set_ylabel("conteggio")
fig.tight_layout()
fig.savefig("istogrammi-bin.svg", metadata={"Date": None})
plt.close(fig)
Uscita ottenuta (Python 3.14.4, NumPy 2.3.5, Matplotlib 3.10.7; il listato è stato eseguito due volte con uscita identica):
sturges : 11 bin
fd      : 11 bin
scott   : 11 bin
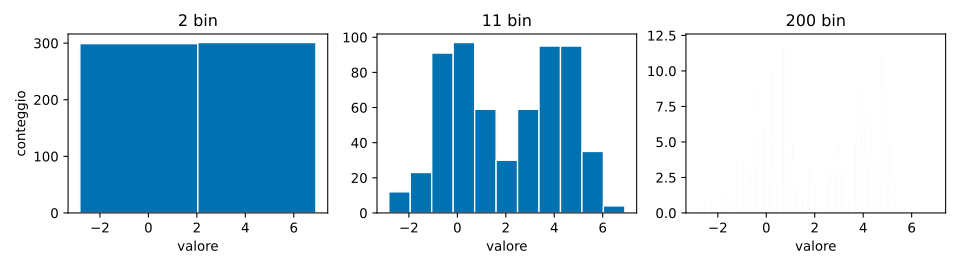
Le tre regole danno tutte 11 bin su questo campione: con 600 punti Sturges calcola ⌈log₂ 600⌉ + 1 = 11, e le due basate sulla dispersione arrivano per caso allo stesso numero perché i dati sono due gaussiane di eguale ampiezza. Non è una regola generale, come vedrai fra poco. Il confronto che conta è visivo: con 2 bin vedi un solo blocco, e i due gruppi non esistono; con 200 bin vedi un pulviscolo; con 11 emergono due colline distinte, con qualche gradino irregolare che è il rumore del campione. Nessuna regola sostituisce l'occhio, ed è buona abitudine provare due o tre valori e verificare che la storia non cambi. Nel codice, plt.subplots(1, 3) crea una riga di tre Axes e restituisce un array da scorrere con zip; edgecolor="white" separa le barre.
Che cosa succede ai bin quando arrivano gli anomali
Le tre regole non reagiscono allo stesso modo ai valori estremi, e questa è la ragione per cui Freedman-Diaconis è considerata la più robusta (la documentazione di NumPy la descrive «resistente ai valori anomali»). Il listato prende 1000 punti normali, aggiunge cinque anomali enormi (da 50 a 90) e confronta le larghezze dei bin delle tre regole sul campione pulito e su quello sporco. Le larghezze si leggono direttamente dai bordi restituiti da histogram_bin_edges. Nello stesso listato, in coda, ci sono le due misure citate prima: il numero di bin predefinito di np.histogram e il valore di figure.max_open_warning.
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

rng = np.random.default_rng(1)
dati = rng.normal(0, 1, 1000)
sporchi = np.concatenate([dati, [50.0, 60.0, 70.0, 80.0, 90.0]])
for etichetta, campione in (("puliti", dati), ("con 5 anomali", sporchi)):
    larghezze = []
    for metodo in ("sturges", "scott", "fd"):
        bordi = np.histogram_bin_edges(campione, bins=metodo)
        larghezze.append(f"{metodo}={bordi[1] - bordi[0]:.3f}")
    print(f"{etichetta:14s}", " | ".join(larghezze))
print("bins predefinito di np.histogram:", np.histogram(dati)[0].size, "| rcParams max_open_warning:", plt.rcParams["figure.max_open_warning"])
Uscita ottenuta (Python 3.14.4, NumPy 2.3.5, Matplotlib 3.10.7; il listato è stato eseguito due volte con uscita identica):
puliti         sturges=0.664 | scott=0.332 | fd=0.261
con 5 anomali  sturges=8.504 | scott=1.765 | fd=0.267
bins predefinito di np.histogram: 10 | rcParams max_open_warning: 20
Sul campione pulito le larghezze sono 0.664 (Sturges), 0.332 (Scott) e 0.261 (Freedman-Diaconis). Con cinque anomali Sturges salta a 8.504, perché la sua larghezza è l'intervallo dei dati diviso per un numero di bin che dipende solo da n, e l'intervallo è diventato enorme: tutti i dati veri finiscono in uno o due bin. Scott sale a 1.765, perché la deviazione standard eleva al quadrato gli scostamenti e gli anomali la gonfiano. Freedman-Diaconis passa da 0.261 a 0.267: lo scarto interquartile guarda solo il 50% centrale e gli anomali non lo spostano. Il prezzo di questa robustezza è che, se gli anomali sono la parte interessante dei dati, il bin che ne risulta non li copre: vanno trovati con un altro grafico, il boxplot, che è fatto apposta.
Esercizio 1
Quanti bin, e perché proprio quelli
Un panificio pesa le pagnotte che escono dai suoi due forni. Applica le tre formule della sezione precedente, carta e penna: i numeri sono scelti perché i conti vengano esatti.
- Con
n = 256pesate, quanti bin suggerisce Sturges? Perché il risultato è un intero esatto? - Con
n = 1000pesate e scarto interquartile15 g, quanto vale la larghezza di Freedman-Diaconis? Perché anche qui il conto è esatto? - Con gli stessi
n = 1000e deviazione standard20 g, quanto vale la larghezza di Scott? Se aggiungessi tre pagnotte difettose da 2 kg, quale delle due larghezze cambierebbe di più?
Prima di aprire la soluzione prova a rispondere almeno alle prime due domande: servono solo una potenza di due e una radice cubica di mille, e se i conti non tornano vale la pena rileggere le formule nella sezione sugli istogrammi.
Mostra la soluzione
1. k = ⌈log₂ 256⌉ + 1 = 8 + 1 = 9 bin. È esatto perché 256 = 2⁸: il logaritmo in base 2 vale 8 senza arrotondamenti, e il soffitto non ha nulla da arrotondare.
2. h = 2 · IQR · n^(-1/3) = 2 · 15 · (1/10) = 3.0 g. Esatto perché 1000 = 10³, quindi n^(-1/3) = 1/10 esatto.
3. h = 3.49 · 20 · 0.1 = 6.98 g, più del doppio. Le due regole misurano la dispersione in modo diverso: Scott usa la deviazione standard, Freedman-Diaconis lo scarto interquartile. Tre pagnotte da 2 kg in mezzo a mille da mezzo chilo gonfierebbero molto la deviazione standard, che eleva al quadrato gli scostamenti, e lascerebbero quasi fermo lo scarto interquartile, che guarda solo il 50% centrale dei dati. Cambia quindi di più la larghezza di Scott; è lo stesso effetto che il listato precedente ha misurato con cinque anomali.
Assi che ingannano
In un grafico a barre l'informazione sta nella lunghezza. Se l'asse non parte da zero, la lunghezza smette di essere proporzionale al valore e le differenze si gonfiano. Tufte (1983) ha dato un nome alla misura dell'inganno, il fattore di menzogna (lie factor): la dimensione dell'effetto mostrato nel grafico divisa per la dimensione dell'effetto nei dati. Un grafico onesto vale 1. Il listato prende due valori, 100 e 104, calcola la differenza vera (4%), calcola la differenza che l'occhio vede se l'asse parte da 98 (le barre diventano lunghe 2 e 6) e le divide. Disegna poi le stesse barre con i due assi. Uso barre orizzontali (barh): la lunghezza codifica il valore allo stesso modo, e cambia solo l'asse da troncare, che è quello orizzontale (set_xlim).
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

plt.rcParams["svg.hashsalt"] = "mle"
valori = np.array([100.0, 104.0])

effetto_dati = (valori[1] - valori[0]) / valori[0]              # 4 %
base_taglio = 98.0
altezze_viste = valori - base_taglio                            # 2 e 6
effetto_grafico = (altezze_viste[1] - altezze_viste[0]) / altezze_viste[0]
print(f"differenza nei dati     : {effetto_dati:.1%}")
print(f"differenza vista a occhio: {effetto_grafico:.1%}")
print(f"fattore di menzogna      : {effetto_grafico / effetto_dati:.0f}")

fig, assi = plt.subplots(1, 2, figsize=(7, 3))
for ax, base, titolo in zip(assi, (98, 0), ("asse da 98: inganna", "asse da 0: onesto")):
    ax.barh(["A", "B"], valori, color=["#56B4E9", "#D55E00"])
    ax.set_xlim(base, 106)
    ax.set_title(titolo)
fig.tight_layout()
fig.savefig("assi-che-ingannano.svg", metadata={"Date": None})
plt.close(fig)
Uscita ottenuta (Python 3.14.4, NumPy 2.3.5, Matplotlib 3.10.7; il listato è stato eseguito due volte con uscita identica):
differenza nei dati     : 4.0%
differenza vista a occhio: 200.0%
fattore di menzogna      : 50
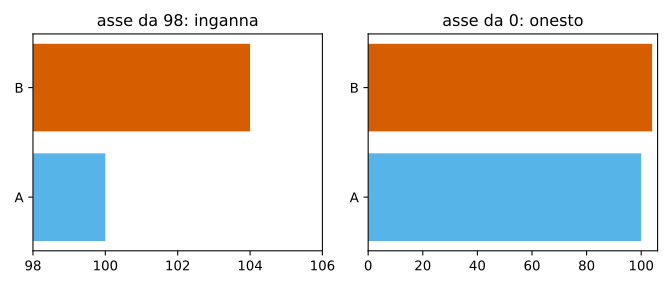
Una differenza del 4% appare come un triplo di lunghezza: l'occhio vede un aumento del 200% e il fattore di menzogna è 50. Per le barre l'asse parte da zero, sempre. Per un grafico a linee il discorso cambia: la linea codifica la posizione, non la lunghezza da una base, e un asse che non parte da zero può essere legittimo per mostrare un andamento; resta l'obbligo di dichiarare l'intervallo e di non confrontare le pendenze di grafici con scale diverse. Esistono altri modi di ingannare, anche senza volerlo: un doppio asse verticale (la correlazione apparente dipende dalla scelta delle due scale), i grafici tridimensionali con prospettiva (la profondità altera le aree), le torte con troppi spicchi, le scale non lineari non dichiarate.
Esercizio 2
Quanto mente questa figura
Il rapporto mensile del panificio mette a confronto due giornate con un grafico a barre: 250 e 260 pagnotte sfornate. L'asse verticale parte da 240.
- Qual è la variazione presente nei dati, in percentuale?
- Quanto sono alte le due barre sul foglio, e di quanto varia l'altezza in percentuale?
- Calcola il fattore di menzogna. Che cosa succederebbe se l'asse partisse da
250?
Il procedimento è identico a quello del listato della sezione precedente: prima l'effetto nei dati, poi l'effetto sul foglio dopo aver tolto la base dell'asse, infine il rapporto fra i due. Segui gli stessi tre passi con i numeri del panificio.
Mostra la soluzione
1. (260 - 250) / 250 = 0.04, cioè il 4%.
2. Le altezze viste sono 250 - 240 = 10 e 260 - 240 = 20: la seconda barra è alta il doppio della prima, una variazione del 100%.
3. 100% / 4% = 25. Un grafico onesto vale 1; questo moltiplica per venticinque l'effetto che il lettore percepisce. Con l'asse a 250 la prima barra avrebbe altezza zero, la variazione relativa non sarebbe nemmeno definita e il fattore sarebbe infinito: la figura trasformerebbe «il 4% in più» in «esiste contro non esiste».
Il quartetto di Anscombe
Nel 1973 Francis Anscombe pubblicò quattro piccoli insiemi di dati, di 11 coppie (x, y) ciascuno, costruiti per avere le stesse statistiche riassuntive. Voleva smentire l'idea che i calcoli bastino e che il grafico sia un'inutile decorazione. Nel listato i quattro insiemi stanno in un dizionario di tuple, la struttura descritta nella lezione su liste, tuple, dizionari e insiemi; per ciascuno si stampano medie, varianza di y (con ddof=1, la varianza campionaria), correlazione di Pearson (np.corrcoef) e i coefficienti della retta ai minimi quadrati (np.polyfit(x, y, 1), che restituisce pendenza e intercetta). Poi una griglia 2×2 con assi condivisi (sharex=True, sharey=True, per rendere i quattro grafici confrontabili direttamente) disegna i punti e la retta.
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

plt.rcParams["svg.hashsalt"] = "mle"
x1 = np.array([10, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5], dtype=float)
x4 = np.array([8, 8, 8, 8, 8, 8, 8, 19, 8, 8, 8], dtype=float)
quartetto = {
    "I":   (x1, np.array([8.04, 6.95, 7.58, 8.81, 8.33, 9.96, 7.24, 4.26, 10.84, 4.82, 5.68])),
    "II":  (x1, np.array([9.14, 8.14, 8.74, 8.77, 9.26, 8.10, 6.13, 3.10, 9.13, 7.26, 4.74])),
    "III": (x1, np.array([7.46, 6.77, 12.74, 7.11, 7.81, 8.84, 6.08, 5.39, 8.15, 6.42, 5.73])),
    "IV":  (x4, np.array([6.58, 5.76, 7.71, 8.84, 8.47, 7.04, 5.25, 12.50, 5.56, 7.91, 6.89])),
}

print("insieme | media x | media y | var y | corr  | pendenza | intercetta")
for nome, (x, y) in quartetto.items():
    pend, interc = np.polyfit(x, y, 1)
    r = np.corrcoef(x, y)[0, 1]
    print(f"{nome:7s} | {x.mean():7.2f} | {y.mean():7.2f} | {y.var(ddof=1):5.2f} | {r:5.3f} | {pend:8.3f} | {interc:9.2f}")

fig, assi = plt.subplots(2, 2, figsize=(7, 5), sharex=True, sharey=True)
retta_x = np.array([3, 20])
for ax, (nome, (x, y)) in zip(assi.ravel(), quartetto.items()):
    pend, interc = np.polyfit(x, y, 1)
    ax.scatter(x, y, color="#0072B2")
    ax.plot(retta_x, pend * retta_x + interc, color="#D55E00")
    ax.set_title(f"Insieme {nome}")
fig.tight_layout()
fig.savefig("anscombe.svg", metadata={"Date": None})
plt.close(fig)
Uscita ottenuta (Python 3.14.4, NumPy 2.3.5, Matplotlib 3.10.7; il listato è stato eseguito due volte con uscita identica):
insieme | media x | media y | var y | corr  | pendenza | intercetta
I       |    9.00 |    7.50 |  4.13 | 0.816 |    0.500 |      3.00
II      |    9.00 |    7.50 |  4.13 | 0.816 |    0.500 |      3.00
III     |    9.00 |    7.50 |  4.12 | 0.816 |    0.500 |      3.00
IV      |    9.00 |    7.50 |  4.12 | 0.817 |    0.500 |      3.00
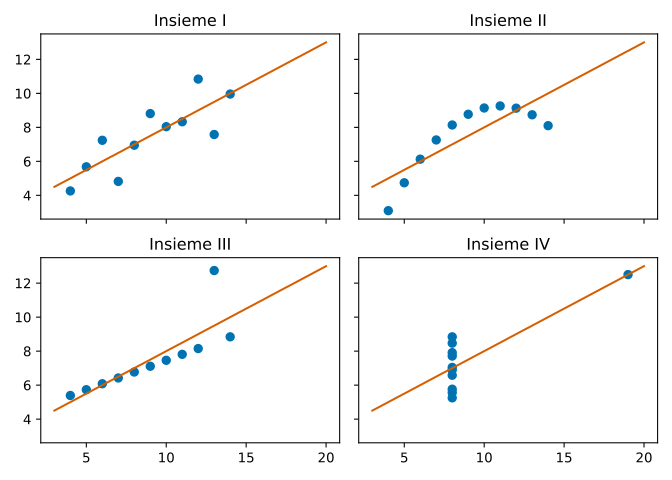
La tabella dice che i quattro insiemi sono, a due o tre decimali, la stessa cosa: medie 9.00 e 7.50, correlazione 0.816 (0.817 per il IV), retta y ≈ 3 + 0.5·x. Il grafico racconta quattro storie. L'insieme I è una nuvola con una relazione lineare plausibile, e la retta la descrive bene. Il II è una curva: la relazione non è lineare e la retta è il modello sbagliato. Nel III i punti stanno su una retta quasi perfetta, e un solo punto anomalo la inclina e abbassa la correlazione. Nel IV x è costante in dieci casi su undici, quindi nel gruppo grande non c'è relazione tra x e y, e un solo punto isolato crea da solo tutta la correlazione. I valori sono quelli del lavoro originale, riportati da me a mano da una fonte che non ho potuto aprire (vedi in fondo); che le statistiche coincidano lo verifichi tu stesso nell'uscita sopra. La lezione operativa: la correlazione è un riassunto che vale solo se la forma della relazione è quella che si assume. Prima di fidarti di una correlazione, di una regressione o di una media, guarda i dati.
Troppi punti: la sovrapposizione
Con un diagramma a dispersione di molte migliaia di punti, i punti si sovrappongono e il grafico diventa una macchia uniforme dove non si legge la densità. I rimedi classici sono due: rendere i punti trasparenti (alpha), così le zone dense risultano più scure, oppure contare i punti in celle esagonali e colorare per densità (hexbin). Il listato genera 30 000 punti con una relazione lineare più rumore e li disegna nei tre modi; mincnt=1 nasconde gli esagoni vuoti, come descrive la documentazione di Axes.hexbin, e fig.colorbar aggiunge la scala dei conteggi.
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

plt.rcParams["svg.hashsalt"] = "mle"
rng = np.random.default_rng(9)
n = 30_000
x = rng.normal(0, 1, n)
y = 0.6 * x + rng.normal(0, 0.8, n)
print("correlazione dei dati:", round(float(np.corrcoef(x, y)[0, 1]), 3), "| punti:", n)

fig, assi = plt.subplots(1, 3, figsize=(11, 3.2), sharex=True, sharey=True)
assi[0].scatter(x, y, s=6, color="#0072B2")
assi[0].set_title("scatter semplice")
assi[1].scatter(x, y, s=6, color="#0072B2", alpha=0.05)
assi[1].set_title("alpha = 0.05")
esagoni = assi[2].hexbin(x, y, gridsize=35, cmap="viridis", mincnt=1)
assi[2].set_title("hexbin")
fig.colorbar(esagoni, ax=assi[2], label="punti per cella")
fig.tight_layout()
fig.savefig("overplotting.svg", metadata={"Date": None})
plt.close(fig)
Uscita ottenuta (Python 3.14.4, NumPy 2.3.5, Matplotlib 3.10.7; il listato è stato eseguito due volte con uscita identica):
correlazione dei dati: 0.593 | punti: 30000

La correlazione dei dati è 0.593. Nel primo pannello 30 000 punti opachi formano una macchia blu: si capisce che c'è una nuvola ma non dove sia più densa. Nel secondo, con alpha=0.05 (trasparenza del 95% per ogni punto), i punti si sommano e le zone dense appaiono più scure: emergono la forma ellittica e il centro più fitto. Nel terzo l'hexbin conta quanti punti cadono in ciascun esagono e li colora con viridis. Il punto non è estetico: con grandi quantità di dati, un grafico che mostra solo i punti singoli nasconde la distribuzione. Per scegliere i due parametri, alpha e gridsize, non c'è una formula: si provano alcuni valori finché la struttura che vedi resiste a un piccolo cambiamento.
Colori, etichette, accessibilità
Un grafico corretto può comunque essere illeggibile. Due regole di buon senso: etichetta sempre assi e unità («valore» non dice nulla, «temperatura (°C)» sì), e scrivi un titolo che enunci la conclusione («le vendite crescono del 12% in aprile») invece del tipo di grafico. Il colore richiede più attenzione. Una pagina di Okabe e Ito dedicata al Color Universal Design riporta che circa un maschio su dodici tra le persone di origine caucasica (8%) ha un daltonismo rosso-verde, uno su venti tra gli asiatici (5%), uno su venticinque tra gli africani (4%): in una sala di 250 persone ce ne sono più di dieci. Rosso e verde sono la coppia che più spesso si confonde, e per questo non devono essere l'unica differenza fra due serie. Nelle figure di questa lezione uso i colori della palette di Okabe e Ito (#0072B2, #D55E00, #56B4E9, ripresi dalla trascrizione esadecimale diffusa della loro palette; la pagina la presenta come immagine, quindi i valori non li ho riletti da testo). Non affidarti nemmeno solo al colore: aggiungi forma del marcatore o stile di linea, perché la figura potrebbe essere stampata in bianco e nero.
Per le mappe di colori che rappresentano un'intensità la guida alla scelta delle mappe di Matplotlib raccomanda mappe percettivamente uniformi, in cui passi uguali nei dati sono percepiti come passi uguali nel colore: viridis, la mappa predefinita, è una di queste. La stessa pagina mostra che jet ha una luminosità che varia in modo irregolare lungo la scala, ed è una scelta povera per rappresentare i dati; l'effetto pratico è che nell'arcobaleno compaiono bande che l'occhio legge come differenze che nei dati non ci sono.
Errori tipici
| Sintomo | Causa | Rimedio |
|---|---|---|
| Due barre sembrano molto diverse, e i dati no | asse troncato su un grafico a barre | asse da zero; per ingrandire una differenza usa un grafico a punti con l'intervallo di incertezza |
| L'istogramma cambia forma al variare dei bin | non è un bug: è il compromesso tra distorsione e rumore | prova più valori e mostra solo ciò che resiste |
| Una nuvola nera in cui non si vede nulla | troppi punti sovrapposti | alpha= basso, marcatori piccoli, hexbin oppure ax.hist2d |
| La memoria cresce in un ciclo di figure | plt.close dimenticato |
chiudi sempre la figura dopo savefig |
| Il grafico è diverso su macchine diverse | backend, font o versione della libreria | fissa il backend, salva in formato vettoriale, dichiara le versioni |
| Il grafico sembra provare una causa | una nuvola di punti mostra associazione, non causalità | dillo nel titolo e nel testo; la causa si argomenta fuori dal grafico |
Quasi tutte queste righe hanno la stessa radice: il grafico fa dire ai dati qualcosa che non dicono, per una scelta di scala, di bin o di sovrapposizione fatta senza guardarne l'effetto. La difesa è la stessa in ogni caso: cambiare la scelta e controllare che la conclusione resti in piedi.
Prima di consegnare una figura
- Disegna prima di calcolare, e di nuovo dopo aver modellato (i residui, le previsioni contro i valori veri).
- Usa l'interfaccia a oggetti e passa gli
axalle funzioni di disegno: il codice resta riusabile. - Una figura, un messaggio: se ne servono due, fai due figure.
- Salva da codice, non con uno screenshot, perché la figura deve poter essere rigenerata.
- Dichiara i dati: da dove vengono, quanti punti, quale periodo.
Questi cinque controlli sono indipendenti tra loro e puoi applicarli nell'ordine che preferisci; il primo è quello che si salta più spesso, ed è quello che avrebbe fatto accorgere subito dei tre anomali nel campione dei tempi di risposta o del punto isolato nel quarto insieme di Anscombe.
Mini-progetto
Genera con NumPy, con un seme fissato, due campioni normali da 500 punti con medie 0 e 0.3 e deviazione standard 1, e lavora sui passi seguenti.
- Disegna i due istogrammi sovrapposti con
alpha=0.5e lo stesso insieme di bin, calcolato una sola volta connp.histogram_bin_edgessui dati uniti. - Calcola le medie campionarie e scrivi in due righe se dal solo grafico sapresti dire che le medie sono diverse.
- Aggiungi due linee verticali tratteggiate in corrispondenza delle medie.
- Salva in
svge inpnga 150 dpi e confronta le dimensioni dei file.
Usare gli stessi bin per i due campioni è il punto del primo passo: con bin diversi il confronto visivo non è più onesto, perché le barre non sono più contate sugli stessi intervalli. Il secondo passo ti obbliga a ragionare su una domanda che la statistica affronta formalmente con i test d'ipotesi: una differenza di 0.3 deviazioni standard si vede a occhio?
Sfide
- Easy. Riproduci il grafico a barre con asse troncato per tre valori (100, 101, 103) e calcola il fattore di menzogna tra il primo e l'ultimo.
- Medium. Disegna la funzione di ripartizione empirica di un campione (ordina i dati e traccia
i/ncontro il valore ordinato) e confrontala con l'istogramma: quale dei due non dipende da una scelta di bin? - Hard. Costruisci un tuo «quartetto»: due insiemi con la stessa media e la stessa varianza ma forma molto diversa (per esempio uno normale e uno bimodale). Verifica con
np.mean,np.vare con il grafico. - Expert. Nel listato degli anomali, cambia numero e valore degli anomali e osserva come crescono le larghezze di Sturges, Scott e Freedman-Diaconis. A quale numero di anomali anche Freedman-Diaconis comincia a muoversi, e perché?
- Enterprise. Prendi un rapporto interno della tua organizzazione che contiene un grafico a barre o a linee, misura il fattore di menzogna, verifica che gli assi abbiano le unità e riscrivi la figura con un titolo che enunci la conclusione.
La sfida Expert ha una risposta che si può prevedere: lo scarto interquartile dipende dal 75° percentile, quindi Freedman-Diaconis dovrebbe muoversi poco finché gli anomali sono una piccola frazione del campione e saltare quando ne superano circa un quarto. Una mia prova (seme 1, 1000 punti normali più anomali tutti pari a 60) ha dato una larghezza di 0.267 con 5 anomali, 0.290 con 100, 0.429 con 300 e 10.59 con 400: va nella direzione prevista, ma prima di fidartene rifai la prova con i tuoi numeri. Se hai fatto la Hard, guarda cosa dice la correlazione del tuo quartetto, e confrontala con quella di Anscombe.
Nella prossima lezione, scikit-learn: stimatori, pipeline e validazione, passi dall'array al modello, con il metodo per non ingannare te stesso: la separazione tra dati di addestramento e di prova.
Nella stessa serie trovi anche: 11 - Numeri in virgola mobile: perché 0.1 + 0.2 non fa 0.3, 23 - Algebra lineare 1: vettori, matrici, sistemi (che richiamano questa lezione).
Fonti
- Matplotlib, Quick start guide - la distinzione fra stile a oggetti (esplicito) e stile con pyplot (implicito); consultata il 2026-11-12
- NumPy, numpy.histogram_bin_edges - descrizione dei metodi sturges, fd, scott e auto (quella di fd come robusta agli anomali, quella di auto come minimo fra sturges e fd); consultata il 2026-11-12
- Matplotlib, Axes.boxplot - baffi entro 1.5 volte lo scarto interquartile, parametro orientation; consultata il 2026-11-12
- Matplotlib, Axes.hexbin - significato di mincnt; consultata il 2026-11-12
- Matplotlib, Choosing Colormaps in Matplotlib - mappe percettivamente uniformi e il caso di jet; consultata il 2026-11-12
- M. Okabe e K. Ito, Color Universal Design (CUD) - frequenza del daltonismo rosso-verde nei maschi (8%, 5%, 4% per gruppo); consultata il 2026-11-12
Riferimenti bibliografici citati nel testo che non ho potuto aprire (i siti degli editori rispondono 403 ai richiami automatici, e non ho verificato le pagine): F. J. Anscombe, Graphs in Statistical Analysis, The American Statistician 27(1), 1973; E. R. Tufte, The Visual Display of Quantitative Information, Graphics Press, 1983; W. S. Cleveland e R. McGill, Graphical Perception, Journal of the American Statistical Association 79(387), 1984; H. A. Sturges, The Choice of a Class Interval, JASA 21(153), 1926; D. W. Scott, On Optimal and Data-Based Histograms, Biometrika 66(3), 1979; D. Freedman e P. Diaconis, On the Histogram as a Density Estimator: L2 Theory, 1981. Quel che ne riporto (il fattore di menzogna, la graduatoria dei compiti percettivi, le tre regole dei bin) è noto in letteratura, ma i dettagli non sono stati riletti sulla fonte originale.
Commenti
Caricamento commenti...
Accedi per commentare