Corso Machine Learning Engineer · Modulo 00 · Mindset data-driven · Lezione 1
Obiettivo. Dare al lettore un modello mentale solido di che cosa sia l'IA, dove stia il machine learning dentro di essa, e perché "imparare dai dati" è una tecnica di ingegneria e non magia. Alla fine il lettore sa distinguere un sistema a regole da un sistema appreso, sa leggere la definizione formale di apprendimento, e sa perché il solo "funziona sul mio dataset" non basta mai.
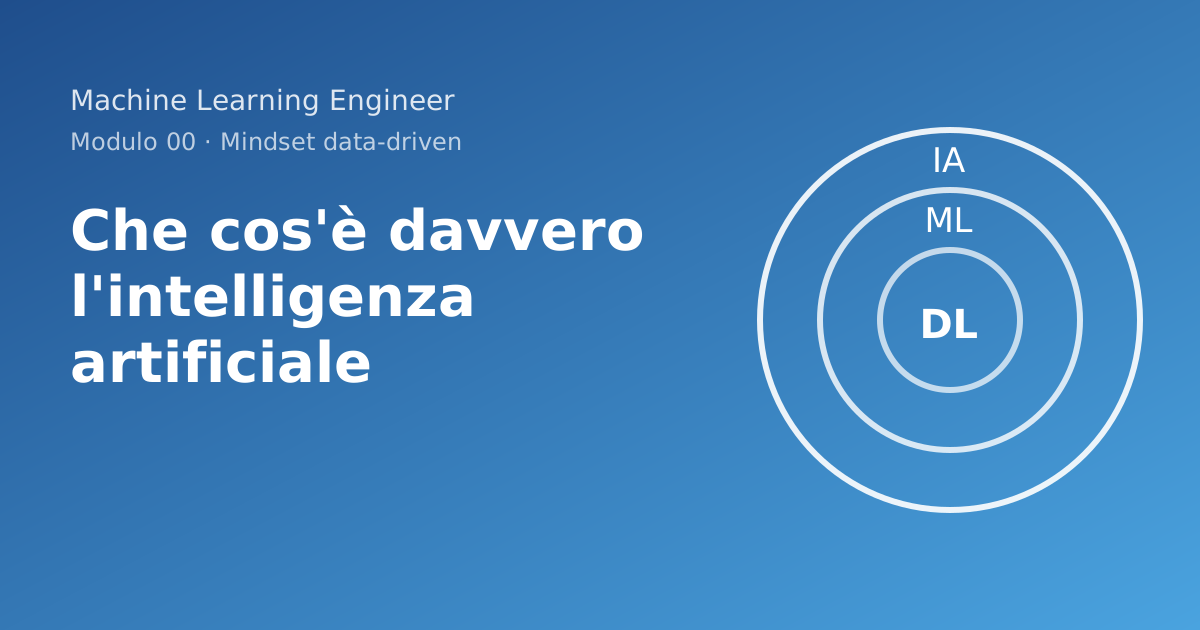
Falso mito da sfatare. "IA", "machine learning" e "deep learning" sono sinonimi. Non lo sono: sono insiemi annidati.
Introduzione
Questa è la prima lezione del corso. Ti accompagno da "ho sentito parlare di IA" a "so costruire, valutare e mettere in produzione un modello". Il percorso è lineare: prima il modo di pensare (modulo 00), poi gli attrezzi (Python, modulo 01), poi la matematica che regge tutto (modulo 02), poi i modelli.
Risultato finale di questa lezione. Saprai spiegare in tre frasi che cosa distingue un programma tradizionale da un programma appreso, e avrai eseguito sul tuo computer un esperimento che lo dimostra con i numeri.
Roadmap della lezione.
- Programmare contro apprendere (l'idea centrale).
- La definizione formale, per intero, senza saltare passaggi.
- Le matrioske: IA ⊃ ML ⊃ DL.
- I tre modi di imparare.
- Generalizzare: la differenza tra memorizzare e capire.
- Quando il machine learning è la scelta sbagliata.
L'ordine non è casuale: la definizione formale poggia sull'idea di programma appreso, la gerarchia IA-ML-DL e i tre paradigmi la usano come vocabolario, e la sezione sui limiti ha senso solo dopo aver visto che cosa il ML sa fare. Se hai fretta, leggi almeno la prima e l'ultima voce: sono quelle che cambiano le decisioni di un progetto.
Cos'è, perché esiste, quando NON usarlo
Il problema che l'IA prova a risolvere
Ci sono compiti che sappiamo fare senza saper spiegare come. Riconosci il volto di un amico in mezzo a una folla; non sapresti scrivere le istruzioni passo-passo che il tuo cervello esegue. Se non sai scrivere le istruzioni, non puoi scrivere il programma tradizionale. Il machine learning nasce da questo vicolo cieco: invece di scrivere le istruzioni, mostri degli esempi, e lasci che sia una procedura a ricavare le istruzioni.
Chi l'ha inventata e quando
La storia è utile perché smonta l'idea che l'IA sia "nuova". Le tappe sono verificabili sulle fonti primarie:
- 1950: Alan Turing pubblica Computing Machinery and Intelligence su Mind. Propone di sostituire la domanda "le macchine possono pensare?" con un gioco di imitazione, oggi detto test di Turing.
- 1955-1956: McCarthy, Minsky, Rochester e Shannon scrivono la proposta per il workshop estivo di Dartmouth; è in quel documento che compare l'espressione "artificial intelligence" come nome di un campo di ricerca.
- 1958: Frank Rosenblatt descrive il percettrone, un modello che aggiusta dei pesi a partire dagli esempi. Lo costruirai da zero nel modulo 04.
- 1959: Arthur Samuel pubblica il lavoro sul programma che impara a giocare a dama, usando l'espressione machine learning nel titolo.
- 1997: Tom Mitchell fissa nel suo manuale la definizione operativa di apprendimento che useremo tra poco.
Le date sono quelle dei documenti, non quelle della leggenda. La proposta di Dartmouth porta la data del 31 agosto 1955 e chiede due mesi di studio per dieci persone nell'estate del 1956: è un progetto di ricerca, e la sua ipotesi di partenza è che ogni aspetto dell'apprendimento possa essere descritto con tanta precisione da poterlo simulare con una macchina. Non scrivo date di «inverni» o di «svolte» del deep learning senza una fonte: quando le incontreremo nei moduli successivi citerò il paper originale accanto a ogni affermazione.
Quando NON usare il machine learning
Questa è la sezione più importante della lezione, e quella che i corsi omettono. Il machine learning è la scelta sbagliata quando:
| Situazione | Perché il ML è sbagliato | Cosa usare |
|---|---|---|
| Le regole sono note, stabili e scrivibili (calcolo dell'IVA, ordinamento) | Un modello approssima ciò che potresti scrivere esattamente. Introduci errore dove non serve | Codice deterministico |
| Hai poche decine di esempi | Il modello memorizza invece di generalizzare | Regole di dominio, statistica descrittiva |
| Un errore costa molto e deve essere spiegabile punto per punto | Un modello dà probabilità, non garanzie | Regole + revisione umana |
| Non hai modo di misurare se funziona | Senza metrica non puoi distinguere un modello utile da uno inutile | Prima costruisci la misura |
| I dati di domani non assomigliano a quelli di ieri | Il modello impara il passato | Monitoraggio, o niente modello |
Regola pratica del corso: prima di ogni modello si costruisce una baseline (la risposta più stupida possibile). Se il modello non batte la baseline, non hai un modello: hai complessità.
Un secondo esempio, contrastante: dove le regole vincono
Per capire il confine del concetto serve anche un caso in cui il machine learning non conviene. Supponi di dover calcolare l'imposta su un prezzo con un'aliquota fissa (qui, per esempio, il 22%): la regola è nota, esatta e stabile. Proviamo comunque ad «apprenderla» da esempi, come se non la conoscessimo, e confrontiamo.
import numpy as np
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(0)
prezzi = rng.uniform(5, 500, size=200)
imposta_vera = 0.22 * prezzi
# le etichette reali sono arrotondate al centesimo, come in una fattura vera
etichette = np.round(imposta_vera, 2)

regola = lambda p: 0.22 * p                                   # il programma tradizionale
modello = LinearRegression().fit(prezzi.reshape(-1, 1), etichette)  # il programma appreso

nuovi = np.array([10.0, 99.99, 480.0])
print("regola    :", np.round(regola(nuovi), 4))
print("modello   :", np.round(modello.predict(nuovi.reshape(-1, 1)), 4))
print("coefficiente appreso:", round(float(modello.coef_[0]), 6), "| intercetta appresa:", round(float(modello.intercept_), 6))
print("errore massimo del modello su 3 prezzi nuovi:", float(np.abs(modello.predict(nuovi.reshape(-1, 1)) - regola(nuovi)).max()))
Output ottenuto:
regola    : [  2.2     21.9978 105.6   ]
modello   : [  2.2007  21.9984 105.6002]
coefficiente appreso: 0.219999 | intercetta appresa: 0.000664
errore massimo del modello su 3 prezzi nuovi: 0.0006533298278665889
Come leggere il codice. prezzi sono 200 prezzi casuali; le etichette sono l'imposta vera arrotondata al centesimo (una piccola imperfezione, come nei dati reali). regola è la funzione scritta da una persona. LinearRegression().fit(...) è la procedura che cerca una retta a·prezzo + b che si adatti agli esempi: reshape(-1, 1) trasforma il vettore dei prezzi in una colonna, perché scikit-learn vuole una matrice di forma (n_esempi, n_caratteristiche) (lezione 5 del modulo 01). Le due previsioni sono praticamente uguali, ma il modello ha trovato un coefficiente molto vicino, non identico, a 0.22, e un'intercetta minuscola ma non zero: ha imparato anche il rumore dell'arrotondamento.
Che cosa ci dice. In un caso come questo il modello non offre alcun vantaggio e introduce tre difetti: un errore (piccolo ma non nullo) dove la regola è esatta, la dipendenza dai dati (se l'aliquota cambia, la regola si corregge in una riga, il modello va riaddestrato con dati nuovi), e la perdita di spiegabilità (la regola si legge, i coefficienti appresi si interpretano). Il machine learning conviene quando la regola non si sa scrivere; quando si sa scrivere, scrivila.
Il percorso di un progetto in una pagina
Prima di entrare nella teoria, ecco il filo conduttore dell'intero corso. Ogni progetto di machine learning serio ha la stessa forma: si separano i dati in parti con ruoli diversi, si addestra su una parte, si sceglie guardando un'altra, e solo alla fine si giudica con una terza, mai usata per scegliere.
Le tre parti hanno nomi precisi, che userai sempre:
- Training set (insieme di addestramento): gli esempi da cui la procedura ricava il modello.
- Validation set (insieme di validazione): esempi mai usati per addestrare, con cui si confrontano modelli e iperparametri (gli iperparametri sono le manopole che scegli tu prima dell'addestramento, come il grado di un polinomio).
- Test set: esempi tenuti in un cassetto, usati una sola volta per dare il giudizio finale. Se lo guardi più volte per decidere, smette di essere un test e diventa un secondo validation set: il numero che ottieni è ottimista.
La divisione in tre parti serve a rendere onesto il numero finale: il validation set è il banco di prova dove sbagli a basso costo, il test set è l'esame. La documentazione di scikit-learn la chiama una pratica comune proprio perché ripetere sugli stessi dati l'addestramento e il giudizio produce un punteggio perfetto e inutile.
Nell'esperimento dei polinomi qui sotto, il «test» che usiamo per mostrare il gap è in realtà quello che, in un progetto vero, chiameremmo validazione; la distinzione tra i due si approfondisce nella lezione su scikit-learn.
Installazione e verifica
Il corso richiede Python 3.12 o successivo. Creiamo un ambiente isolato (la lezione 1 del modulo 01 spiega perché) e verifichiamo le versioni.
python3 -m venv .venv
source .venv/bin/activate          # su Windows: .venv\Scripts\activate
python -m pip install --upgrade pip
pip install numpy scikit-learn
python -c "import numpy, sklearn; print(numpy.__version__, sklearn.__version__)"
Se vedi due numeri di versione, sei pronto. Il codice di questa lezione è stato eseguito con NumPy 2.3 e scikit-learn 1.8; con versioni diverse i numeri casuali potrebbero cambiare nelle ultime cifre, ma il ragionamento no.
Primo esempio: un programma a regole contro un programma appreso
L'analogia: la ricetta contro l'apprendista
Un programma tradizionale è una ricetta: qualcuno ha già capito come si fa il piatto e scrive ogni passaggio. L'esecutore non capisce nulla, esegue.
Un programma appreso è un apprendista cuoco che assaggia migliaia di piatti riusciti e falliti, e a poco a poco regola le dosi finché i suoi piatti assomigliano a quelli riusciti. Nessuno gli ha dato la ricetta: la ricetta è il risultato dell'allenamento.
In termini di ingegneria: nel programma tradizionale l'umano scrive la funzione f. Nel programma appreso l'umano scrive la procedura che cerca f, e fornisce gli esempi.
L'esperimento
Costruiamo un filtro antispam giocattolo. Ogni messaggio è descritto da due numeri: quanti punti esclamativi contiene e quanti link. I dati sono simulati da noi (e dichiarati tali): lo spam tende ad averne di più. Confrontiamo:
- una regola scritta a mano da un umano ("spam se almeno 3 esclamativi e almeno 1 link");
- una soglia appresa dai dati (cerca il valore di
esclamativi + linkche massimizza l'accuratezza sugli esempi).
Le due strategie rispondono alla stessa domanda con ingredienti diversi: la prima usa un'intuizione umana, la seconda la verifica su cinquemila esempi. Il codice che segue le confronta su messaggi mai visti durante la ricerca della soglia, perché confrontarle sugli stessi esempi premierebbe chi ha memorizzato di più.
import numpy as np

rng = np.random.default_rng(42)

def genera_messaggi(n, p_spam, rng):
    """Restituisce (X, y). X ha due colonne: n. esclamativi, n. link.
    y vale 1 se spam. Lo spam ha mediamente più esclamativi e più link."""
    y = rng.random(n) < p_spam
    esclam = np.where(y, rng.poisson(3.0, n), rng.poisson(0.5, n))
    link = np.where(y, rng.poisson(2.0, n), rng.poisson(0.4, n))
    return np.column_stack([esclam, link]), y.astype(int)

def regola_umana(X):
    """Programma tradizionale: la funzione f l'ha scritta una persona."""
    return ((X[:, 0] >= 3) & (X[:, 1] >= 1)).astype(int)

def impara_soglia(X, y):
    """Programma appreso: la procedura cerca la soglia migliore sugli esempi."""
    punteggio = X.sum(axis=1)
    migliore, soglia_migliore = -1.0, None
    for soglia in range(0, int(punteggio.max()) + 2):
        acc = ((punteggio >= soglia).astype(int) == y).mean()
        if acc > migliore:
            migliore, soglia_migliore = acc, soglia
    return soglia_migliore

def accuratezza(pred, y):
    return (pred == y).mean()

X_tr, y_tr = genera_messaggi(5000, 0.30, rng)   # esempi con cui "allenare"
soglia = impara_soglia(X_tr, y_tr)
print("soglia appresa:", soglia)

X_te, y_te = genera_messaggi(5000, 0.30, rng)   # esempi MAI visti
print("regole umane  :", round(accuratezza(regola_umana(X_te), y_te), 3))
print("soglia appresa:", round(accuratezza((X_te.sum(axis=1) >= soglia).astype(int), y_te), 3))
print("baseline 'sempre non-spam':", round(accuratezza(np.zeros_like(y_te), y_te), 3))
Output ottenuto (seed 42, NumPy 2.3.5):
soglia appresa: 3
regole umane  : 0.848
soglia appresa: 0.914
baseline 'sempre non-spam': 0.701
Leggilo con calma. La baseline "dichiara tutto non-spam" ottiene circa il 70% senza guardare nulla, perché il 30% dei messaggi è spam e il 70% no. Questa cifra è il pavimento: ogni modello va giudicato rispetto a essa, non rispetto allo zero.
Cosa è cambiato davvero
Nel secondo caso nessuno ha scritto "3". Il 3 è uscito dai dati. Se domani il tuo problema cambia, cambi i dati e rilanci la procedura; non riscrivi la logica. Questo è il guadagno. Il prezzo è che ora il programma dipende da dati che possono essere sbagliati, vecchi o non rappresentativi.
Esercizio 1
Dov'è il pavimento?
Nell'esperimento qui sopra il 30% dei messaggi è spam e la baseline «dichiara tutto non-spam» arriva a circa 0.70. Rifai il conto con numeri diversi, carta e penna, senza eseguire codice.
- Su 1000 messaggi, di cui 50 spam, quanto vale l'accuratezza della baseline «sempre non-spam»?
- Un modello annuncia «accuratezza 0.95» su quegli stessi 1000 messaggi. Che cosa hai imparato sul modello?
- Scrivi T, E e P di questo problema in una riga ciascuno, e di' quale delle tre cambieresti per rendere il numero informativo.
Le tre domande vanno in ordine di difficoltà: la prima è solo un conto, la seconda ti chiede di interpretarlo, la terza di rimettere in discussione la misura. Prova a rispondere prima di aprire la soluzione, anche solo a mente: il punto dell'esercizio è accorgerti da solo che il 95% non dice nulla.
Mostra la soluzione
1. La baseline indovina tutti i 950 non-spam e sbaglia tutti i 50 spam: 950 / 1000 = 0.95. Il pavimento è al 95%, non allo zero.
2. Niente. Quel modello pareggia la baseline: potrebbe essere il filtro antispam più raffinato del mondo oppure la riga return 0. L'accuratezza non li distingue, perché una classe domina.
3. T: «classificare un messaggio come spam o no». E: «1000 messaggi etichettati, 50 dei quali spam». P: «frazione di messaggi nuovi classificati correttamente». Quella da cambiare è P: con classi sbilanciate serve una misura che guardi la classe rara — precisione e richiamo sullo spam, non l'accuratezza complessiva. Cambiare T o E non servirebbe: il compito e i dati sono quelli, è il metro a essere sbagliato.
Teoria: la definizione di apprendimento, per intero
Definizione di Mitchell (1997)
Si dice che un programma impara dall'esperienza E rispetto a una classe di compiti T e a una misura di prestazione P, se la sua prestazione sui compiti in T, misurata da P, migliora con l'esperienza E.
Tre ingredienti, e tutti obbligatori:
- T (task): "classificare un messaggio come spam o no".
- E (experience): "5000 messaggi con l'etichetta giusta".
- P (performance): "frazione di messaggi nuovi classificati correttamente".
Se non riesci a riempire tutte e tre le caselle, non hai ancora un problema di machine learning: hai un'intuizione. Compilarle è già il primo lavoro del ML engineer.
Dalla definizione alla formula
Tradurre in matematica significa dare un nome a ogni oggetto. Sono sei passaggi, e ciascuno dipende dal precedente.
- Un esempio è una coppia
(x, y):xsono le caratteristiche (qui due numeri),yè la risposta giusta (spam / non spam). - Esiste una famiglia di funzioni candidate
F. Nell'esempio: tutte le funzioni "somma ≥ soglia" al variare della soglia. Un modello è un elementofdiF. - Una funzione di perdita
ℓ(ŷ, y)misura quanto costa rispondereŷquando la verità èy. Per la classificazione,ℓ = 0se hai indovinato e1altrimenti. - Il rischio atteso è la perdita media su tutti i messaggi possibili, presenti e futuri:
R(f) = E[ ℓ(f(x), y) ]. Non lo conosci mai, perché non hai tutti i messaggi possibili. - Il rischio empirico è la perdita media sugli
nesempi che hai:R̂(f) = (1/n) · Σᵢ ℓ(f(xᵢ), yᵢ). - L'apprendimento (minimizzazione del rischio empirico, formalizzata da Vapnik) è
f̂ = argmin_{f ∈ F} R̂(f).
L'ordine di lettura è dalla definizione all'obiettivo: i primi tre passaggi dicono che cosa osservi e come misuri un errore, il quarto dice che cosa vorresti minimizzare, gli ultimi due che cosa puoi davvero minimizzare. Tutto il resto del corso è il modo in cui si colma la distanza tra il quarto e il quinto.
"Scegli, tra le funzioni candidate, quella che sbaglia meno sugli esempi che hai."
Nel codice, impara_soglia è esattamente questo argmin: prova tutte le soglie (la famiglia F), calcola la perdita media sugli esempi, tiene la migliore.
Perché c'è un problema: R̂ non è R
Quello che minimizzi (R̂) non è quello che ti interessa (R). La differenza R(f̂) − R̂(f̂) si chiama gap di generalizzazione. Se F è piccola (una sola soglia), il gap è piccolo. Se F è enorme (una tabella che associa a ogni esempio visto la sua risposta), puoi ottenere R̂ = 0 e R pessimo: hai memorizzato.
Analogia. Uno studente che impara a memoria le risposte del libro di esercizi prende il massimo sugli esercizi del libro (R̂ = 0) e fallisce l'esame con numeri diversi (R alto). Lo studente che ha capito il metodo prende un voto simile su entrambi.
Dimostrazione numerica: il gap cresce con la complessità
Adattiamo polinomi di grado crescente a dati rumorosi. Il grado è la "complessità" di F. I dati sono generati da noi: una curva seno più rumore.
import numpy as np

rng = np.random.default_rng(0)

def verita(x):
    return np.sin(2 * np.pi * x)

x_tr = rng.uniform(0, 1, 15)
y_tr = verita(x_tr) + rng.normal(0, 0.25, 15)
x_te = rng.uniform(0, 1, 500)
y_te = verita(x_te) + rng.normal(0, 0.25, 500)

print("grado | errore train | errore test")
for grado in (1, 3, 5, 9, 14):
    coef = np.polyfit(x_tr, y_tr, grado)
    mse_tr = np.mean((np.polyval(coef, x_tr) - y_tr) ** 2)
    mse_te = np.mean((np.polyval(coef, x_te) - y_te) ** 2)
    print(f"{grado:5d} | {mse_tr:12.4f} | {mse_te:11.4f}")
Output ottenuto (seed 0, NumPy 2.3.5):
grado | errore train | errore test
    1 |       0.1566 |      0.3838
    3 |       0.0265 |      0.0631
    5 |       0.0244 |      0.0653
    9 |       0.0159 |      1.3991
   14 |       0.0000 | 299472011.8134
Leggi la tabella colonna per colonna. L'errore sul training scende sempre al crescere del grado, fino a zero: un polinomio di grado 14 passa esattamente per 15 punti. L'errore sul test scende fino al grado 3-5 (circa 0.06, vicino alla varianza del rumore che abbiamo aggiunto, 0.25² = 0.0625: meglio di così non si può fare) e poi esplode. Il valore a grado 14 è un numero assurdo, non un errore di stampa: il polinomio oscilla violentemente tra i punti di training. È il sintomo di un problema mal condizionato, argomento del modulo 02. Il grado giusto per questi 15 punti sta tra 3 e 5.
Come leggere la tabella, riga per riga. Ogni riga è un modello diverso: un polinomio di grado g ha g + 1 coefficienti liberi, quindi più grado significa più «manopole». Con grado 1 (una retta) il modello è troppo rigido: sbaglia sia sui dati che ha visto (0.157) sia su quelli nuovi (0.384): è sottoadattamento (underfitting). Con grado 3 e 5 gli errori sui due insiemi sono bassi e vicini: il modello ha colto la struttura. Con grado 9 l'errore sul training continua a scendere (0.016) ma quello sul test sale a 1.4: il modello ha cominciato a inseguire il rumore dei 15 punti. Con grado 14 passa esattamente per tutti i punti (errore 0) e fuori da essi oscilla in modo assurdo: è il sovradattamento (overfitting) portato all'estremo, e il numero enorme nel test (dell'ordine di 10⁸) è il sintomo di un problema di calcolo oltre che statistico: la matrice con cui si adatta un polinomio così è mal condizionata (lo vedremo con i numeri nella lezione di algebra lineare 1, dove calcoleremo proprio quel condizionamento).
La regola da portare via. L'errore sul training non misura la qualità del modello: misura la sua capacità di memorizzare. L'unico numero che informa è quello su dati che il modello non ha mai visti.
Trade-off. Più capacità del modello = meno errore sul training, più rischio di overfitting, più dati necessari. Meno capacità = underfitting (il modello non cattura nemmeno la struttura vera). Non esiste la complessità "migliore" in assoluto; esiste quella adatta ai tuoi dati.
Esercizio 2
Memorizzare non è imparare
Il magazzino ricambi di un concessionario di macchine agricole (scenario simulato, numeri scelti perché i conti vengano interi) vuole decidere, per ogni codice articolo, se riordinarlo. Due candidati:
- A, una tabella di consultazione: memorizza la risposta giusta per ciascuno dei 500 codici storici e risponde cercando il codice. Se il codice non c'è, risponde «non riordinare».
- B, una sola regola su due caratteristiche (richieste nell'ultimo anno, giorni dall'ultima richiesta).
A è il caso estremo di famiglia F enorme: una riga per ogni codice visto. B appartiene a una famiglia minuscola, due soglie. I numeri che seguono servono a vedere che cosa succede al rischio empirico e al rischio vero quando le due famiglie si confrontano con codici mai visti.
Sui 500 codici storici A indovina 500 volte, B 420. In un mese arrivano 200 richieste: 160 per codici già in tabella e 40 per codici nuovi. Sui codici noti A indovina 144 volte; sui nuovi la sua risposta di ripiego è giusta 10 volte. B indovina l'84% delle volte su entrambi i tipi, perché non ha bisogno di aver già visto il codice.
- Calcola l'accuratezza empirica (sui 500) e quella reale (sui 200) di entrambi.
- Quale dei due ha il gap di generalizzazione più grande? Perché?
- Scrivi T, E e P, e di' quale pezzo dell'impostazione ha reso il gap invisibile.
Tieni a portata di mano la definizione di Mitchell: la terza domanda è un esercizio di lettura di T, E e P, non di calcolo. Le prime due richiedono solo di distinguere con attenzione gli esempi con cui A è stato costruito dagli esempi che arriveranno nel mese, che sono due popolazioni diverse.
Mostra la soluzione
1. Empirica: A 500/500 = 1.00, B 420/500 = 0.84. Reale: A (144 + 10)/200 = 154/200 = 0.77, B 0.84 × 200 = 168, quindi 168/200 = 0.84. La classifica si ribalta: A vince di 16 punti sui dati con cui è stato costruito e perde di 7 su quelli che contano.
2. A, con un gap di 1.00 − 0.77 = 0.23; quello di B è zero. A ha rischio empirico esattamente 0 e rischio vero 0.23 — l'illustrazione più netta possibile di R̂ ≠ R. Il meccanismo ha un nome preciso: A non ha un'ipotesi sul perché un ricambio venga richiesto, ha una copia del passato. Sul 20% di codici mai visti una copia del passato non ha niente da dire, e 30 di quelle 40 richieste vanno sbagliate.
3. T: «decidere se riordinare un codice articolo». E: «500 codici storici con l'esito della decisione». P: «frazione di decisioni corrette». A rendere il gap invisibile è stato misurare P su E. Qualunque modello capace di memorizzare prende 1.00 in quel modo, e quel numero non dice nulla sul futuro. È tutta la ragione per cui i dati si dividono, ed è l'argomento della lezione successiva.
Una nota pratica che vale più dell'aritmetica: i 23 punti di gap di A non sono distribuiti uniformemente. Stanno tutti sul 20% di codici nuovi — cioè proprio sulla popolazione che interessa al magazzino, visto che i ricambi che tiene già a scaffale non sono il problema. Anche una media calcolata su tutto il mese li avrebbe nascosti.
Codice: la gerarchia e i tre paradigmi
Le matrioske: IA ⊃ ML ⊃ DL
- Intelligenza artificiale: il campo, l'ombrello. Russell e Norvig la organizzano intorno all'idea di agente razionale: qualcosa che percepisce e agisce per raggiungere un obiettivo. Include anche sistemi senza apprendimento (motori di ricerca nello spazio degli stati, sistemi esperti a regole).
- Machine learning: il sottoinsieme dell'IA in cui il comportamento è ricavato dai dati anziché scritto a mano.
- Deep learning: il sottoinsieme del ML che usa reti neurali con molti strati. Lo costruiremo dal modulo 04.
- IA generativa: modelli (spesso deep) che producono contenuto nuovo (testo, immagini) invece di assegnare un'etichetta. Modulo 10.
I primi tre termini sono insiemi annidati, il quarto è un asse diverso: descrive che cosa il modello produce, non come è fatto. Per questo un'IA generativa è quasi sempre deep learning, ma un classificatore deep non è generativo. Quando senti «IA» in una riunione, chiedi a quale cerchio si riferisce chi parla.
Un termostato con la regola "se T < 19 accendi" è un agente, quindi IA in senso lato, ma non ML. Una regressione lineare è ML ma non deep. Una rete a 50 strati è deep learning.
I tre paradigmi, con analogia e codice
1. Apprendimento supervisionato: lo studente con il libro delle soluzioni. Hai esempi con la risposta giusta. Impari a prevederla per esempi nuovi. Classificazione (categoria) o regressione (numero).
2. Apprendimento non supervisionato: l'esploratore senza mappa. Hai esempi senza risposta. Cerchi struttura: gruppi, anomalie, dimensioni nascoste.
3. Apprendimento per rinforzo: il cane e i biscotti. Nessun esempio etichettato: un agente prova azioni, riceve ricompense, e impara una strategia. Modulo 08.
import numpy as np
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.cluster import KMeans

X, y = load_iris(return_X_y=True)

# 1) SUPERVISIONATO: uso le etichette y
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)
albero = DecisionTreeClassifier(max_depth=3, random_state=0).fit(X_tr, y_tr)
print("supervisionato, accuratezza test:", round(albero.score(X_te, y_te), 3))

# 2) NON SUPERVISIONATO: ignoro y, chiedo 3 gruppi
km = KMeans(n_clusters=3, n_init=10, random_state=0).fit(X)
print("dimensioni dei gruppi trovati:", np.bincount(km.labels_))

# 3) RINFORZO: bandito a 3 braccia con strategia epsilon-greedy
def bandito(prob_vittoria, passi=2000, eps=0.1, seed=1):
    rng = np.random.default_rng(seed)
    stima = np.zeros(len(prob_vittoria))
    prove = np.zeros(len(prob_vittoria))
    totale = 0.0
    for _ in range(passi):
        if rng.random() < eps:                      # esplora
            a = rng.integers(len(prob_vittoria))
        else:                                       # sfrutta
            a = int(np.argmax(stima))
        r = float(rng.random() < prob_vittoria[a])  # ricompensa 0 o 1
        prove[a] += 1
        stima[a] += (r - stima[a]) / prove[a]       # media incrementale
        totale += r
    return stima, prove, totale / passi

stima, prove, medio = bandito([0.2, 0.5, 0.7])
print("stime:", stima.round(2), "| prove per braccio:", prove.astype(int), "| ricompensa media:", round(medio, 2))

# Output (NumPy 2.3.5, scikit-learn 1.8.0, due esecuzioni identiche):
# supervisionato, accuratezza test: 0.956
# dimensioni dei gruppi trovati: [62 50 38]
# stime: [0.14 0.53 0.7 ] | prove per braccio: [  88   66 1846] | ricompensa media: 0.67
Leggi le tre righe come tre esperimenti diversi. L'albero, con le etichette a disposizione, indovina 0.956 degli esempi di test su iris. KMeans trova gruppi da 62, 50 e 38 fiori senza aver mai visto un'etichetta: la specie vera è 50-50-50, quindi la corrispondenza è parziale, e questo è esattamente il problema del non supervisionato. Il bandito manda 1846 prove su 2000 sul braccio migliore (probabilità 0.7), pagando in esplorazione le altre 154: la ricompensa media 0.67 è il compromesso fra le due cose.
Tre note sul codice:
stratify=ymantiene le proporzioni delle classi nei due sottoinsiemi: con classi sbilanciate evita split sfortunati.KMeansnon conosce i nomi dei fiori: trova tre gruppi guardando solo le misure. Che i gruppi corrispondano alle specie lo verifichiamo dopo, non lo sa l'algoritmo.- Nel bandito,
stima[a] += (r - stima[a]) / prove[a]è la media incrementale: si dimostra in una riga. Sem_n = (1/n)·Σ rᵢ, alloram_n = m_{n-1} + (r_n − m_{n-1})/n, perchén·m_n = (n−1)·m_{n-1} + r_n. Lo useremo di nuovo nel modulo 08.
Trade-off dei paradigmi. Il supervisionato richiede etichette, che costano (qualcuno deve produrle). Il non supervisionato non le richiede ma il risultato è più difficile da valutare ("quanti gruppi?" non ha una risposta oggettiva). Il rinforzo richiede un ambiente in cui provare e sbagliare è economico.
Un vocabolario minimo
Ti serviranno in ogni lezione: li fissiamo ora, una volta per tutte.
- Caratteristica (feature): una misura descrittiva di un esempio (età, numero di link). Un esempio ha un vettore di caratteristiche.
- Etichetta (label, o target): la risposta che vorremmo prevedere (spam sì/no, prezzo).
- Modello: la funzione che, date le caratteristiche, restituisce una previsione.
- Addestramento (training): la procedura che sceglie il modello dentro la famiglia di modelli candidati.
- Funzione di perdita: il costo di una singola previsione sbagliata.
- Generalizzazione: la capacità di funzionare su esempi mai visti.
- Sovradattamento / sottoadattamento: memorizzare il rumore / non cogliere nemmeno la struttura.
- Baseline: la risposta più semplice possibile, con cui ogni modello va confrontato.
Le otto parole si raggruppano in tre famiglie: i dati (caratteristica, etichetta), la procedura (modello, addestramento, perdita), il giudizio (generalizzazione, sovradattamento e sottoadattamento, baseline). Se in una discussione qualcuno mescola le famiglie, per esempio chiamando «modello» il dataset, la confusione si risolve riportando ciascun termine alla sua riga.
Errori tipici (sintomo → causa → rimedio)
- "Il mio modello ha il 99% di accuratezza!" Causa possibile: classi sbilanciate. Se il 99% dei messaggi non è spam, dire sempre "non spam" dà 99%. Rimedio: confronta con la baseline, usa precisione/richiamo (modulo 03).
- Valutare sugli stessi dati usati per allenare.
Sintomo: risultati spettacolari in laboratorio, delusione in produzione. Causa: misuri
R̂, nonR. Rimedio: dati di test mai toccati durante l'allenamento. - Il mondo cambia (distribution shift). Un modello è una fotografia del passato. Rimedio: monitorare le metriche nel tempo e prevedere un riaddestramento (modulo 11).
- Etichette sbagliate. "Garbage in, garbage out": un modello perfetto sui dati sbagliati impara l'errore.
- Confondere correlazione e causa. Il modello vede che i gelati e gli annegamenti crescono insieme. Entrambi dipendono dall'estate. Prevedere non è spiegare.
- Scegliere il modello guardando il test. Sintomo: il risultato finale è sempre un po' migliore di quello che si ottiene in produzione. Causa: il test è diventato parte del processo di scelta. Rimedio: validazione per scegliere, test una volta sola.
- Dimenticare che le etichette sono prodotte da persone o da regole. Un modello che impara a prevedere «quali candidati sono stati assunti in passato» impara le scelte del passato, errori compresi. Rimedio: chiedersi sempre da dove vengono le etichette e se misurano ciò che ci interessa davvero.
- Mancato confronto con la baseline. Un modello che «ha il 94% di accuratezza» non dice nulla se la classe più frequente vale già il 93%. Rimedio: riportare sempre la baseline accanto al risultato.
Gli otto errori hanno due radici: o sbagli la misura (1, 2, 6, 8) o sbagli i dati e il loro rapporto con il mondo (3, 4, 5, 7). I primi si correggono con la disciplina dello split e della baseline, i secondi richiedono di capire da dove vengono le etichette, e nessun algoritmo lo fa al posto tuo.
Best practice
- Baseline prima, modello poi. Sempre.
- Scrivi T, E, P prima di toccare il codice.
- Fissa il seed (
default_rng(42),random_state=0) per riprodurre i risultati. - Separa i dati prima di guardarli troppo: ciò che hai visto influenza le tue scelte.
- Dichiara le versioni delle librerie: i numeri casuali non sono garantiti identici tra versioni.
- Un modello semplice che puoi spiegare batte uno complesso che non sai difendere, a parità di prestazioni.
Le sei regole costano quasi nulla e proteggono dagli errori della sezione precedente. Se devi sceglierne una per un progetto con poco tempo, scegli la prima: la baseline decide in cinque minuti se il resto del lavoro ha senso. Seme e versioni servono invece a far rifare il tuo esperimento a un collega con lo stesso risultato.
Mini-progetto
Prendi il dataset dei fiori (load_iris) e:
- Scrivi T, E, P in una riga ciascuno.
- Costruisci la baseline "classe più frequente" (
sklearn.dummy.DummyClassifier(strategy="most_frequent")). - Allena l'albero di decisione con profondità 1, 2, 3, 5, 10 e riporta accuratezza su train e test.
- Scrivi cinque righe: dove l'albero smette di migliorare sul test? Che cosa ti dice questo sulla capacità del modello?
Il mini-progetto ripete con un albero di decisione l'esperimento che hai visto con i polinomi: la profondità dell'albero fa da «grado», e la baseline DummyClassifier da pavimento. Per costruirla, la documentazione di scikit-learn dice che con strategy="most_frequent" il metodo predict restituisce sempre la classe più frequente osservata in fit.
Consegna: uno script che stampa una tabella simile a quella dei polinomi.
Challenge
- Easy. Cambia
p_spamda 0.30 a 0.05 nell'esperimento antispam. Come cambia la baseline? Cosa significa che il modello ha "il 95%"? - Medium. Modifica
impara_sogliaper cercare soglie diverse suesclame sulinkseparatamente (due soglie, regola AND). Batte la soglia sulla somma? - Hard. Nel bandito, varia
epsin {0, 0.01, 0.1, 0.5}. Per ciascuno ripeti 50 volte con seed diversi e disegna la ricompensa media. Quale è meglio e perché? - Expert. Dimostra che, per la perdita 0-1 e due soglie uguali di accuratezza, la scelta della più bassa o più alta cambia il comportamento sul tipo di errore (falsi positivi contro falsi negativi). Quando vorresti l'una o l'altra?
- Enterprise. Scrivi una pagina: per un processo della tua organizzazione (reale o immaginario), compila T, E, P e dichiara in quale riga della tabella "Quando NON usare il ML" potrebbe finire.
Le cinque sfide crescono per ambizione: Easy e Medium si risolvono modificando una riga del codice dell'articolo, Hard richiede un ciclo sui semi, Expert una dimostrazione con carta e penna, Enterprise un ragionamento sul tuo lavoro. Se ne fai una sola, falla sull'ultima: è quella che trasferisce l'articolo fuori dal notebook.
Codice di questa lezione
Tre esercizi di codice sui temi della lezione: la baseline sulle classi sbilanciate, una famiglia di modelli più grande (due soglie invece di una) e il gap di generalizzazione con i polinomi. Scheletro con le parti da completare e, in fondo, le soluzioni commentate. Richiede Python 3.12+ e NumPy 2.3.
Eseguilo con python3 esercizi.py: gira anche con le parti non completate e ti dice quali mancano; il file è nella cartella di download del sito e si apre con un normale editor di testo.
Recap
Mappa mentale. IA (ombrello) → ML (impara dai dati) → DL (reti profonde). ML = (T, E, P). Apprendere = minimizzare il rischio empirico sperando che sia vicino al rischio vero. Tre paradigmi: supervisionato, non supervisionato, rinforzo.
Cheat sheet.
| Simbolo | Significato |
|---|---|
(x, y) |
esempio: caratteristiche e risposta |
F |
famiglia di modelli candidati |
ℓ(ŷ, y) |
costo di un singolo errore |
R(f) |
errore atteso su tutti i dati possibili (non misurabile) |
R̂(f) |
errore medio sugli esempi disponibili |
| gap | R − R̂: cresce con la complessità, decresce con più dati |
3 concetti: (T, E, P); rischio empirico contro rischio vero; baseline. 3 errori: valutare sul training; accuratezza su classi sbilanciate; ignorare il cambio di distribuzione. 3 best practice: baseline prima; seed fissato; split prima di esplorare. 1 esercizio: il mini-progetto di questa lezione.
Prossima lezione: gli agenti, ovvero sistemi che non si limitano a prevedere ma agiscono.
Domande per andare avanti
- Se
Rnon si può misurare, come faccio a stimarlo? (Lezione sullo split e la validazione incrociata, modulo 01.) - Perché il polinomio di grado 14 produce un errore di test enorme? Su questa macchina
np.polyfitnon ha emesso alcun avviso: il valore è il segnale del mal condizionamento, e il suo ordine di grandezza dipende dalla libreria di algebra lineare installata. (Condizionamento, modulo 02.) - Come si sceglie la perdita
ℓquando i due errori costano diversamente? (Lezione 04 di questo modulo.)
Le tre domande puntano alle lezioni successive: la prima chiude il cerchio dello split, la seconda quello della matematica, la terza quello della decisione aziendale. Annotale prima di proseguire e verifica, alla fine di ciascuna lezione, se la tua risposta è cambiata.
Nella stessa serie trovi anche: 02 - Dal modello all'agente (la lezione successiva).
Fonti
- A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence (McCarthy, Minsky, Rochester, Shannon, 31 agosto 1955) - la data, la durata dello studio e l'ipotesi di partenza sull'apprendimento simulabile, consultata il 2026-11-12
- scikit-learn: Cross-validation, evaluating estimator performance - la definizione di overfitting e la pratica del test set, consultata il 2026-11-12
- scikit-learn: DummyClassifier - il comportamento di
strategy="most_frequent", consultata il 2026-11-12 - NumPy: numpy.polyfit - il
RankWarningemesso quando la matrice dei coefficienti è deficiente di rango, consultata il 2026-11-12 - Libri e articoli citati nel testo, non raggiunti online: A. M. Turing, Computing Machinery and Intelligence, Mind 59(236), 1950; A. L. Samuel, Some Studies in Machine Learning Using the Game of Checkers, IBM Journal of Research and Development 3(3), 1959; F. Rosenblatt, The Perceptron, Psychological Review 65(6), 1958; T. M. Mitchell, Machine Learning, McGraw-Hill, 1997, cap. 1; S. Russell, P. Norvig, Artificial Intelligence: A Modern Approach, 4ª ed., 2020; V. Vapnik, The Nature of Statistical Learning Theory, Springer, 1995.
I listati Python sono stati eseguiti due volte, con seme fisso, con Python 3.14.4, NumPy 2.3.5 e scikit-learn 1.8.0: le uscite riportate coincidono. L'errore di test del polinomio di grado 14 (dell'ordine di 10⁸) dipende dalla libreria di algebra lineare e può variare da una macchina all'altra. I comandi pip e venv non sono stati eseguiti: sono uno schema da adattare.
Commenti
Caricamento commenti...
Accedi per commentare