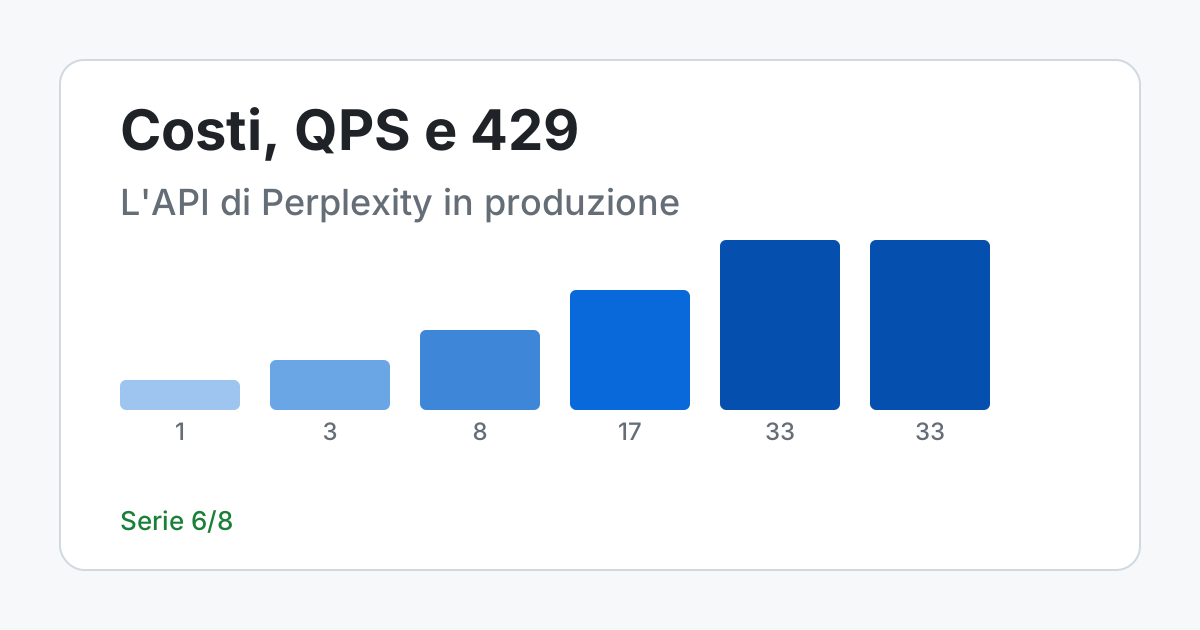
Risposta diretta. Con l'API di Perplexity i limiti dipendono da quanto hai acquistato in tutta la vita dell'account, non dal saldo, e l'Agent API ne ha due: un limite di richieste al secondo per l'intera organizzazione (1 al livello 0, 3 al livello 1, 8 al livello 2, 17 al livello 3, 33 ai livelli 4 e 5) e un limite di token al minuto e all'ora per ciascun modello. Il secondo è quello che sorprende, perché puoi ricevere un 429 anche rimanendo molto sotto il primo. La Search API ha invece 50 unità al secondo per tutti. Qui trovi come distinguere i tre tipi di 429, tre piccoli programmi provati senza il prodotto (ripresa, pacing, tetto di spesa) e come stimare un costo senza conoscerlo tutto.
Due limiti, e il secondo ti sorprende
Una richiesta all'Agent API deve passare due controlli. Il primo è il limite di richieste al secondo (QPS), unico per l'organizzazione e condiviso fra tutti i modelli: ogni chiamata a POST /v1/agent occupa un posto per un secondo, e lo occupano anche il controllo di stato di una esecuzione (GET /v1/agent/{id}), l'annullamento, la ripresa e il download di file. Il secondo è il limite di token, al minuto (TPM) e all'ora (TPH), che vale per organizzazione e per modello: ogni modello ha il suo budget, e il budget conta i token in ingresso, quelli in uscita e quelli di ragionamento, compresi i modelli di supporto usati dentro strumenti come fetch_url.
Entrambi sono condivisi da tutte le chiavi dell'organizzazione, quindi due servizi con chiavi diverse si contendono la stessa quota. Il controllo sui token guarda solo l'utilizzo già registrato: se il budget del modello è già esaurito, la richiesta viene respinta con 429 prima di partire, qualunque sia la sua dimensione. E la richiesta respinta per token conta comunque come una richiesta nel QPS: un ciclo di tentativi serrati sui 429 da token finisce per far scattare anche il limite di richieste.
La tabella dei livelli
| Livello | Credito acquistato (cumulativo) | QPS Agent API | TPM per modello | TPH per modello |
|---|---|---|---|---|
| 0 | 0 $ | 1 | 5.000.000 | 300.000.000 |
| 1 | 50 $ o più | 3 | 6.000.000 | 360.000.000 |
| 2 | 250 $ o più | 8 | 8.000.000 | 480.000.000 |
| 3 | 500 $ o più | 17 | 10.000.000 | 600.000.000 |
| 4 | 1.000 $ o più | 33 | 13.000.000 | 780.000.000 |
| 5 | 5.000 $ o più | 33 | 16.000.000 | 960.000.000 |
Il livello si basa sugli acquisti cumulativi e, una volta raggiunto, non retrocede: il saldo corrente non c'entra. Il passaggio al livello successivo ha effetto immediato. Il salto più utile per chi serve utenti reali è dal livello 0 al livello 1, che triplica il QPS con 50 dollari acquistati; fra livello 4 e livello 5 il QPS non cambia, cambia solo il budget di token.
Per la Search API (POST /search) il limite è invece di 50 unità al secondo, con raffica di 50, uguale per tutti i livelli. Qui fatturazione e limite usano unità diverse: una richiesta con un array di cinque query è una richiesta fatturata (0,005 dollari in modalità standard, 0,001 con search_type: "fast") ma consuma cinque unità di limite. La Search API non ha token, quindi nessun budget di token da esaurire.
I tre 429 e che cosa fare
La documentazione distingue gli errori dell'Agent API leggendo il campo error.type del corpo:
request_rate_limit_exceeded: hai superato il QPS. AspettaRetry-After(normalmente un secondo) e riprova.token_rate_limit_exceeded: hai superato il limite di token e il messaggio indica la finestra (TPMoTPH). Aspetta almenoRetry-Aftere riprova con backoff esponenziale e jitter.overloaded: non è un limite tuo ma la capacità del modello a monte. Riprova con backoff, oppure usa la lista di riservamodels.
Le tre risposte sono diverse perché le cause sono diverse: il primo errore passa da solo in un secondo, il secondo dice che hai consumato un budget e che aspettare è l'unica cura, il terzo non dipende da te e può essere aggirato cambiando modello. Per i limiti di token Retry-After è il tempo necessario perché esca abbastanza utilizzo dalla finestra, più fino a 10 secondi di ritardo casuale aggiunto dal servizio, proprio per non far ripartire tutti i client respinti insieme; non è una prenotazione, perché altre richieste dell'organizzazione possono consumare il budget prima del tuo ritorno.
Il programma seguente implementa questa politica e la prova contro un'API finta che restituisce i tre errori in sequenza, con i corpi copiati dalla pagina (quello di overloaded è un testo inventato per la prova, perché la pagina non ne mostra uno). La funzione attesa sceglie per ciascun tipo: Retry-After più un piccolo jitter per il QPS, il massimo fra Retry-After e un'attesa casuale crescente per token e sovraccarico. Un 429 di tipo sconosciuto non si ritenta: viene rilanciato.
"""Che cosa fare davanti a un 429 dell'Agent API, provato contro un'API finta in-process.

Le due forme del corpo dell'errore e i tre valori di error.type vengono dalla pagina
«Rate limits & usage tiers» di Perplexity, consultata il 2026-11-13.
"""
import json
import random

RICHIESTA = "request_rate_limit_exceeded"   # superato il QPS
TOKEN = "token_rate_limit_exceeded"         # superato TPM o TPH
SOVRACCARICO = "overloaded"                 # capacità del modello a monte, non un tuo limite

CORPO_QPS = '{"error":{"message":"Request rate limit exceeded, please try again later.","type":"request_rate_limit_exceeded","code":429}}'
CORPO_TOKEN = '{"error":{"message":"Token rate limit exceeded (TPM). Retry after the Retry-After interval.","type":"token_rate_limit_exceeded","code":429}}'
CORPO_SOVRACCARICO = '{"error":{"message":"Model overloaded.","type":"overloaded","code":429}}'  # testo inventato per la prova


class Errore429(Exception):
    def __init__(self, corpo, retry_after):
        super().__init__(corpo)
        self.corpo, self.retry_after = corpo, retry_after


class TroppiTentativi(Exception):
    pass


def tipo_errore(corpo):
    try:
        return json.loads(corpo)["error"]["type"]
    except (ValueError, KeyError, TypeError):
        return "sconosciuto"


def attesa(errore, tentativo, rng, base=1.0, tetto=30.0):
    """Secondi da aspettare: mai meno di Retry-After, con jitter sopra."""
    tipo = tipo_errore(errore.corpo)
    if tipo == RICHIESTA:
        return errore.retry_after + rng.uniform(0, 0.5)
    if tipo in (TOKEN, SOVRACCARICO):
        esponenziale = min(tetto, base * 2 ** tentativo)
        return max(errore.retry_after, rng.uniform(0, esponenziale))
    raise errore                      # un 429 che non conosco non si ritenta alla cieca


def chiama(fn, dormi, rng, tentativi=5):
    for n in range(tentativi):
        try:
            return fn()
        except Errore429 as e:
            if n == tentativi - 1:
                raise TroppiTentativi(f"abbandono dopo {tentativi} tentativi") from e
            dormi(attesa(e, n, rng))


def api_finta(esiti):
    """Restituisce una funzione che consuma in ordine la lista di esiti (eccezioni o testo)."""
    coda = list(esiti)

    def fn():
        esito = coda.pop(0)
        if isinstance(esito, Exception):
            raise esito
        return esito
    return fn


if __name__ == "__main__":
    attese = []
    rng = random.Random(7)
    fn = api_finta([Errore429(CORPO_QPS, 1.0), Errore429(CORPO_TOKEN, 12.0),
                    Errore429(CORPO_SOVRACCARICO, 0.0), "risposta"])
    print("risultato:", chiama(fn, attese.append, rng))
    for n, (tipo, s) in enumerate(zip([RICHIESTA, TOKEN, SOVRACCARICO], attese), 1):
        print(f"tentativo {n}: {tipo:28} attesa {s:5.2f} s")

    sempre = api_finta([Errore429(CORPO_TOKEN, 10.0)] * 5)
    attese2 = []
    try:
        chiama(sempre, attese2.append, random.Random(7))
    except TroppiTentativi as e:
        print(f"{e}; attese totali {sum(attese2):.1f} s in {len(attese2)} pause")

    # Secondo controllo, indipendente: sul tipo TOKEN il jitter è uniforme in [0, min(30, 2^n)]
    # quindi, con Retry-After a zero, la media attesa al tentativo 3 vale 8/2 = 4 secondi.
    e0 = Errore429(CORPO_TOKEN, 0.0)
    campione = [attesa(e0, 3, random.Random(s)) for s in range(20000)]
    print(f"media simulata al tentativo 3: {sum(campione) / len(campione):.2f} s (teorica 4.00)")
    assert abs(sum(campione) / len(campione) - 4.0) < 0.1
    assert all(attesa(Errore429(CORPO_TOKEN, 12.0), 0, random.Random(s)) >= 12.0 for s in range(1000))
    print("mai meno di Retry-After su 1000 prove: confermato")

# Comando: python3 ripresa.py
# Output:
# risultato: risposta
# tentativo 1: request_rate_limit_exceeded  attesa  1.16 s
# tentativo 2: token_rate_limit_exceeded    attesa 12.00 s
# tentativo 3: overloaded                   attesa  2.60 s
# abbandono dopo 5 tentativi; attese totali 40.0 s in 4 pause
# media simulata al tentativo 3: 3.95 s (teorica 4.00)
# mai meno di Retry-After su 1000 prove: confermato
Nell'uscita le tre attese hanno forme diverse: poco più di un secondo per il QPS, esattamente 12 secondi per il token (il Retry-After vale più dell'attesa casuale) e 2,60 secondi per il sovraccarico. Il secondo caso mostra che con cinque tentativi e Retry-After di 10 secondi si abbandona dopo 40 secondi di pause: il tetto ai tentativi evita il ciclo che non finisce mai. In fondo, due controlli indipendenti: la media di ventimila attese simulate al tentativo 3 vale 3,95 secondi contro 4,00 teorici (il jitter è uniforme fra 0 e 8) e in mille prove l'attesa non scende mai sotto il Retry-After. Questo programma non sa nulla dei client ufficiali: dove il tuo client già ritenta da solo, prima di aggiungere questo livello controlla che i due non si moltiplichino.
Esiste un caso che questo programma non gestisce, perché non è un errore: se il budget di token si esaurisce mentre una richiesta gira, i token non sono riservati all'avvio, la richiesta va in pausa e riprende da sola. Una pausa non è un errore e non va ripresentata. In streaming puoi vederla impostando stream_options.include_token_pause_events: true, che aggiunge gli eventi response.paused e response.resumed; in modalità background la risposta di GET /v1/agent/{id} riporta status: "in_progress" con un oggetto paused. Senza streaming la pausa si vede solo come latenza: la connessione resta aperta al massimo 30 minuti, e una richiesta che il tuo client abbandona per timeout viene annullata dal servizio anche se è in pausa. Per il lavoro che deve sopravvivere al timeout del client la pagina indica background: true.
Restare sotto il QPS prima che arrivi il 429
Il QPS usa una finestra mobile di un secondo: quando la finestra è vuota le richieste possono arrivare tutte insieme fino al limite, le successive vengono respinte finché le più vecchie non hanno più di un secondo. Aspettare il 429 per scoprirlo è uno spreco, perché ogni respinta occupa comunque un posto. Il programma seguente fa l'operazione inversa: dato un gruppo di richieste che arrivano insieme e il QPS del livello, calcola quando ciascuna può partire. Il tempo è virtuale, nessuna attesa vera.
"""Quando partono N richieste arrivate insieme con una finestra mobile di un secondo.

QPS per livello dalla pagina «Rate limits & usage tiers» di Perplexity, consultata il 2026-11-13.
Il tempo è virtuale: la prova non aspetta davvero.
"""
from collections import deque

QPS_PER_LIVELLO = {0: 1, 1: 3, 2: 8, 3: 17, 4: 33, 5: 33}


def pianifica(n, qps):
    """Istanti di partenza: ogni richiesta occupa un posto per un secondo."""
    partite, orari, t = deque(), [], 0.0
    for _ in range(n):
        while partite and t - partite[0] >= 1.0:
            partite.popleft()
        if len(partite) >= qps:
            t = partite[0] + 1.0              # aspetta che la più vecchia esca dalla finestra
            while partite and t - partite[0] >= 1.0:
                partite.popleft()
        partite.append(t)
        orari.append(t)
    return orari


def picco_in_un_secondo(orari):
    """Controllo a forza bruta: il massimo di partenze in una finestra [t, t+1)."""
    return max(sum(1 for u in orari if t <= u < t + 1.0) for t in orari)


if __name__ == "__main__":
    N = 25                                     # una classe che preme «cerca» nello stesso istante
    print("livello  QPS  ultima partenza  picco in 1 s")
    for livello, qps in QPS_PER_LIVELLO.items():
        orari = pianifica(N, qps)
        picco = picco_in_un_secondo(orari)
        assert picco <= qps                    # mai oltre il limite
        assert orari[-1] == (N - 1) // qps     # formula chiusa: gruppi di qps al secondo
        print(f"{livello:>7}  {qps:>3}  {orari[-1]:>12.0f} s  {picco:>11}")
    print("controllo con forza bruta e formula chiusa: concordano")

# Comando: python3 finestra.py
# Output:
# livello  QPS  ultima partenza  picco in 1 s
#       0    1            24 s            1
#       1    3             8 s            3
#       2    8             3 s            8
#       3   17             1 s           17
#       4   33             0 s           25
#       5   33             0 s           25
# controllo con forza bruta e formula chiusa: concordano
Con 25 richieste simultanee e il livello 0 l'ultima parte dopo 24 secondi; al livello 1 dopo 8; al livello 3 dopo 1 secondo; da 33 QPS in su partono tutte nello stesso istante (nella colonna del picco si vede che le 25 non superano comunque il limite). Il controllo a forza bruta, che conta le partenze in ogni finestra, e la formula chiusa (N-1)//QPS concordano su tutti i livelli. Limiti onesti: questo modello è la finestra descritta dalla documentazione, non una misura del servizio, e un pacing nel tuo processo non vede le richieste degli altri servizi della stessa organizzazione, che condividono la quota. Fa risparmiare 429, non li elimina.
Un tetto di spesa tuo
Il fornitore ti addebita ciò che consumi. Se vuoi che un errore nel tuo codice diventi un'eccezione invece di una fattura, il tetto deve stare nel tuo servizio. Il programma seguente tiene un contatore giornaliero per chiave, in micro-dollari interi (niente numeri a virgola nei conti di denaro): addebita somma il costo di una richiesta e solleva TettoSuperato senza registrare nulla quando il totale supererebbe il tetto. La data arriva da una funzione iniettata, così la prova può far passare un giorno senza aspettarlo.
"""Tetto di spesa giornaliero per chiave, in micro-dollari interi.

Prezzi dalla pagina Pricing di Perplexity, consultata il 2026-11-13:
Search API 5,00 $ ogni mille richieste, 1,00 $ con search_type "fast".
Il contatore è in memoria: vale per un solo processo. Con più processi serve un archivio condiviso.
"""
from datetime import date
from fractions import Fraction

MICRO = 1_000_000
SEARCH_STANDARD = 5_000
SEARCH_FAST = 1_000


class TettoSuperato(Exception):
    pass


class TettoGiornaliero:
    def __init__(self, tetto_micro, oggi):
        self._tetto = tetto_micro
        self._oggi = oggi                      # funzione che restituisce la data: iniettabile nei test
        self._spesa = {}

    def addebita(self, chiave, costo_micro):
        k = (self._oggi(), chiave)
        nuovo = self._spesa.get(k, 0) + costo_micro
        if nuovo > self._tetto:
            raise TettoSuperato(f"{chiave}: {nuovo / MICRO:.3f} $ supera {self._tetto / MICRO:.2f} $")
        self._spesa = {**self._spesa, k: nuovo}   # nuova copia, il vecchio dizionario non si muta
        return nuovo


if __name__ == "__main__":
    giorno = [date(2026, 11, 13)]
    tetto = TettoGiornaliero(10 * MICRO, lambda: giorno[0])      # 10 $ al giorno per chiave

    ammesse = 0
    try:
        while True:
            tetto.addebita("chiave-a", SEARCH_STANDARD)
            ammesse += 1
    except TettoSuperato as e:
        print(f"standard: {ammesse} richieste ammesse, poi: {e}")

    giorno[0] = date(2026, 11, 14)
    tetto.addebita("chiave-a", SEARCH_STANDARD)
    print("il giorno dopo il contatore riparte: ammessa 1 richiesta")

    fast = TettoGiornaliero(10 * MICRO, lambda: giorno[0])
    n = 0
    while True:
        try:
            fast.addebita("chiave-a", SEARCH_FAST)
        except TettoSuperato:
            break
        n += 1
    print(f"fast: {n} richieste ammesse con lo stesso tetto")

    # Secondo calcolo, indipendente: l'esempio della pagina (10.000 richieste standard = 50 $).
    mese = Fraction(10_000) * Fraction("5.00") / 1000
    assert mese == 50 and 10_000 * SEARCH_STANDARD == 50 * MICRO
    assert ammesse == 10 * MICRO // SEARCH_STANDARD and n == 10 * MICRO // SEARCH_FAST
    print("10.000 richieste standard in un mese: 50,00 $ (come l'esempio della pagina)")

# Comando: python3 tetto.py
# Output:
# standard: 2000 richieste ammesse, poi: chiave-a: 10.005 $ supera 10.00 $
# il giorno dopo il contatore riparte: ammessa 1 richiesta
# fast: 10000 richieste ammesse con lo stesso tetto
# 10.000 richieste standard in un mese: 50,00 $ (come l'esempio della pagina)
Con un tetto di 10 dollari e la Search API in modalità standard (0,005 dollari a richiesta) passano 2.000 richieste e la 2.001ª viene respinta; il giorno dopo il contatore riparte; in modalità fast (0,001) passano 10.000 richieste. L'ultima riga conferma, con Fraction, l'esempio della pagina dei prezzi: 10.000 richieste standard in un mese costano 50 dollari. Il contatore è in memoria e vale per un solo processo: con più processi o più macchine serve un archivio condiviso, e quella variante non l'ho eseguita.
Questo contatore sa il prezzo di una richiesta solo dove è fisso, cioè per la Search API. Per l'Agent API il costo dipende dal modello, dai token e dagli strumenti usati: la pagina dei prezzi dice che, quando presente in una risposta completata, usage.cost.total_cost riporta il costo calcolato della richiesta. Registra quel valore a ogni risposta e confrontalo con la fattura dopo due settimane: avrai il costo mediano reale per livello, che è l'unico numero su cui basare un preventivo.
Come stimare un costo senza conoscere tutto
- La parte nota sono gli strumenti: invocazioni per tariffa. A
lowi passi sono 5 e le chiamate parallele sono spente, quindi con una ricerca fast a 0,001 dollari il massimo è 5 × 0,001 = 0,005 dollari di strumenti per richiesta (unfetch_urlcosta 0,0005). - La parte ignota sono i token: misurala su un campione reale di 50-100 richieste per ciascun livello, leggendo i consumi dalle risposte.
- Somma le due parti, aggiungi un margine e correggi dopo due settimane confrontando con la fattura.
L'ordine conta: senza il campione del secondo punto il primo è un numero che sembra preciso e non lo è, e senza il confronto del terzo il margine è un'ipotesi. I livelli di servizio flex (0,5 volte la tariffa dei token) e priority (2 volte) valgono solo per i modelli che li elencano nella pagina dei modelli: controlla quello che usi prima di contarci. Le tariffe degli strumenti non cambiano con il livello di servizio.
Dove i limiti cambiano la progettazione
Due scenari ipotetici; i numeri sono ipotesi dichiarate, i prezzi e i limiti sono quelli documentati oggi.
Una classe, una chiave, 1 richiesta al secondo
Ipotesi: un docente fa usare a 25 studenti un piccolo strumento di ricerca con fonti, con una chiave sua al livello 0. Quando tutti premono «cerca» nello stesso istante, 24 richieste ricevono request_rate_limit_exceeded. Rimedio: una coda lato server che emette al massimo una richiesta al secondo (il programma sopra dice 24 secondi per svuotarla) con il messaggio «sei in coda», oppure il livello 1 (50 dollari acquistati, 3 QPS, 8 secondi). Se lo strumento ha bisogno solo dei risultati e non di una risposta generata, la Search API cambia il problema: 50 unità al secondo per tutti i livelli, quindi 25 richieste non fanno coda, e costano 25 × 0,005 = 0,125 dollari. Cosa va storto: uno studente scrive dati personali nella casella; serve una regola d'uso e il filtro dell'articolo 1, e il docente deve dire che le fonti vanno aperte e lette.
La verifica notturna di 5.000 fornitori
Ipotesi: l'ufficio acquisti di un produttore fa girare ogni notte un job che cerca segnalazioni recenti su 5.000 fornitori. Conti con la Search API: 5.000 × 0,005 = 25 dollari a notte in modalità standard, 5.000 × 0,001 = 5 con la ricerca fast (750 e 150 dollari su 30 notti), e almeno 100 secondi per emettere 5.000 unità a 50 al secondo. Nessun budget di token, nessun 429 da token. Cosa va storto: una segnalazione falsa che blocca un ordine o una mancata che lascia passare un problema. Il sistema produce una lista da far leggere a un acquirente, con fonte e data: il silenzio non è assenza di rischio.
Che cosa sai fare adesso
Sai leggere la tabella dei livelli e dire quale dei due limiti dell'Agent API ti ha respinto, sai scegliere fra attesa, backoff e riserva a seconda del campo error.type, sai pianificare le partenze per restare sotto il QPS, e hai un tetto di spesa che si ferma da solo prima della fattura. Non sai ancora quanto costano i token del tuo carico: va misurato su un campione, non letto da una pagina.
← Articolo 5: Perplexity MCP Articolo 7: PerplexityBot e robots.txt →
Domande frequenti
Qual è il limite di richieste dell'Agent API di Perplexity?
Dipende dal livello, basato sugli acquisti cumulativi: 1 QPS al livello 0, 3 al livello 1, 8 al livello 2, 17 al livello 3, 33 ai livelli 4 e 5. Il limite è condiviso da tutti i modelli e le chiavi dell'organizzazione; i token hanno limiti separati per modello.
Come gestisco un errore 429?
Leggi error.type: per il QPS aspetta Retry-After (di norma un secondo), per i token aspetta almeno Retry-After e poi usa backoff esponenziale con jitter, per overloaded riprova con backoff o usa la lista models di riserva. Limita i tentativi paralleli.
Il polling delle esecuzioni in background conta nei limiti?
Sì, secondo la documentazione conta nel QPS, come annullamento, ripresa e download di file. Fai polling con backoff oppure usa lo streaming con ripresa.
Come metto un tetto alla spesa?
Nel tuo servizio, con un contatore giornaliero per chiave che solleva un errore al superamento. Per la Search API il prezzo per richiesta è fisso; per l'Agent API registra usage.cost.total_cost quando è presente e confrontalo con la fattura.
Fonti
- Perplexity, Rate Limits & Usage Tiers - livelli, QPS, token per minuto e per ora, tipi di 429, pausa dei lavori, limiti della Search API; letta per intero il 13 novembre 2026
- Perplexity, Pricing - tariffe della Search API e degli strumenti, unità di fatturazione,
usage.cost.total_cost, livelli flex e priority; letta per intero il 13 novembre 2026 - Perplexity, Agent API: Effort - passi e chiamate parallele del livello low (versione 2026-11-11.0); sezione sui valori del livello letta il 13 novembre 2026
- Perplexity, Search API: overview - parametri e limiti della richiesta, fino a cinque query per richiesta; letta per intero il 13 novembre 2026
Commenti
Caricamento commenti...
Accedi per commentare